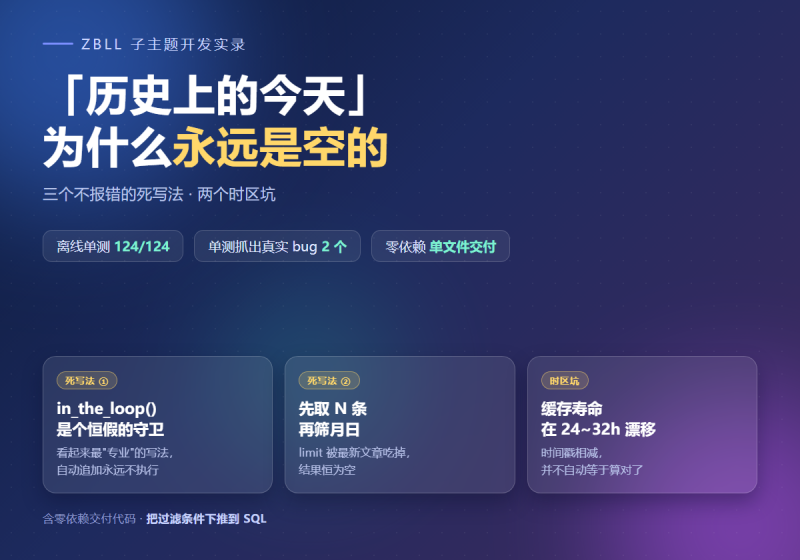
摘要:「N 年前的今天」是个几百行就能写完的小功能:查几篇文章,渲染一个列表。我先写了三版,三版都不报错、页面都能打开,只是没效果 —— 列表空的、自动追加不出现、每次浏览都多打一次数据库。本文记录这三个「看起来完全正确」的死写法,以及写完之后被自己的单测抓出来的两个时区坑:一个让功能每天凌晨列错日期,另一个让缓存寿命在 24~32 小时之间随机漂移。
适合阅读:写过「按日期取内容」类功能的开发者,尤其是踩过「功能明明开着却像没开」或「早上测不对、下午测又对了」的人。文末附零依赖交付代码(124 项离线单测全绿)。
一、先看三个「不报错」的失效
先说一句背景:这个功能的需求本身极其平淡 —— 在每篇文章底部显示「往年的今天你写过什么」。匹配规则就是「月、日相同 + 年份不同」,一个纯查询问题。
之所以值得写下来,是因为它踩到的三个坑全部属于同一类:代码语法正确、逻辑看起来正确、不产生任何警告或异常,只是结果和你以为的不一样。这类问题的排查成本远高于会报错的 bug —— 因为你会不停地在”应该没错”的地方打转。
| 死写法 | 看起来在做什么 | 实际发生了什么 |
|---|---|---|
| `if (in_the_loop())` | 只在主循环的单篇文章里追加 | 条件**恒为 false**,自动追加永不执行 |
| 先取 N 条再 PHP 过滤 | 取最新 N 篇,筛出月日相同的 | 最新 N 篇**与目标月日无关**,几乎必然筛空 |
| 每次浏览都查一次 | 逻辑清晰、没有缓存复杂度 | 功能正常,只是**每个访客每次都多查一次库** |
下面逐条展开。
二、死写法①:in_the_loop() 是个恒假的守卫
这是三个里最值得记的一个,因为它看起来最”专业”。
需求是「只在单篇文章页追加,不要在首页、归档页、相关文章区块里追加」。于是很自然就写成了这样:
add_filter('the_content', function ($content) {
    // 想表达:只在主循环里、并且只处理正文那一篇
    if (!in_the_loop() || !is_singular('post')) {
        return $content;
    }
    return $content . my_render();
});跑起来的结果是:短码能用,但自动追加永远不出现。因为你会怀疑”钩子没挂上”、”主题没调 the_content”、”优先级被别的插件顶掉了”,于是开始一个个加日志去查钩子链 —— 方向全错。
为什么 in_the_loop() 恒为 false
它的实现非常短,问题就藏在这一行里:
// WordPress 源码
function in_the_loop() {
    global $wp_query;
    return $wp_query === $GLOBALS['wp_the_query'];   // ← 比的是 wp_the_query
}
判据是「当前循环实例 === $wp_the_query」。而 $wp_the_query 只在主循环第一次调用 the_post() 时才被赋值:
// wp-includes/class-wp-query.php
public function the_post() {
    global $post;
    if (!isset($this->in_the_loop)) {
        $this->in_the_loop = true;
    }
    if ($this->current_post == -1) {          // ← 第一次
        do_action_ref_array('loop_start', array(&$this));
    }
    $post = $this->next_post();
}
所以在 the_content 过滤器触发时(尤其是块主题、区块预览、或经 AJAX 单独取正文的场景),$wp_the_query 经常还是 null,in_the_loop() 就必然返回 false。它不是”有时为假”,而是”在你需要的那个位置一定为假”。
我在自己的环境里把中间量打出来,得到的正是这一行:
TM_LOOP:in_the_loop=0;is_main=1;qid=581;cid=581注意 qid(被查询的文章 ID)与 cid(当前渲染的文章 ID)都是 581 —— 语义上完全是”正在渲染主文章”,但守卫条件依然判定为假。条件本身的判据选错了,不是数据不对。
正确的判据:直接比较”哪一篇”
想表达”当前渲染的就是被查询的那一篇”,最直接的写法就是比 ID:
// 不要写 in_the_loop();直接比对象 ID
if (!is_singular('post') || is_feed() || is_embed()) {
    return $content;
}
if ((int) get_queried_object_id() !== (int) get_the_ID()) {
    return $content;   // 渲染的是别的文章(相关文章区块等)→ 不追加
}这个判据有两个好处:① 不依赖循环状态,在任何调用路径下语义都一致;② 它顺带解决了另一个问题 —— 相关文章、推荐位这些”在同一页里渲染别的文章”的区块,会因为 ID 不同而被自动排除(用 in_the_loop() 时反而挡不住它们)。
“想表达 A,于是用了看起来代表 A 的内置函数” —— 这类错误不报错、不警告,只会让功能静默失效。判断一个守卫条件是否可靠,唯一标准是读它的实现,而不是读它的名字。
三、死写法②:先取 N 条,再在 PHP 里筛月日 —— limit 被吃掉了
第二个坑更常见,因为它看起来是”标准的两步走”:
// ❌ 这条链在数据量稍大的站点上必然失败
$posts = get_posts(array(
    'posts_per_page' => 8,
    'orderby'        => 'date',
    'order'          => 'DESC',
));

foreach ($posts as $p) {
    if (date('m-d', strtotime($p->post_date)) !== $target_md) {
        continue;                      // 月日不符 → 跳过
    }
    // ……渲染
}问题在于:posts_per_page = 8 取的是「最新的 8 篇」,而”最新的 8 篇”和”某月某日的历史文章”是两件毫不相关的事。在一个发了几百篇的站点上,这 8 篇的月日几乎一定都不等于目标月日 —— 于是筛选结果恒为空,而数据库里明明躺着几十篇匹配的文章。
症状特别容易误判成”数据问题”:
- 换了几个”看起来应该有几篇”的日期去试,**有时有、有时没有**(取决于那个月日恰好离”最新”有多近)
- 直接查数据库 `SELECT … WHERE MONTH(post_date)=10 AND DAY(post_date)=9` 却**能查到一堆**
- 于是开始怀疑 `date_query` 语法、怀疑时区、怀疑 post_status —— 全都不对
根因很简单:你在取数据的时候就已经把需要的数据丢掉了,后面的过滤只是在剩下的渣里找。过滤条件必须下推到 SQL。
正确的下推写法(年月日三个都要给)
$args = array(
    'post_type'      => 'post',
    'post_status'    => 'publish',
    'posts_per_page' => $limit + 2,      // 多取 2 条,见下
    'ignore_sticky_posts' => true,

    'date_query' => array(
        array(
            'year'     => $years,          // 区间:[2021,2022,2023,2024,2025]
            'monthnum' => $month,          // ← 关键:年月日拆开写
            'day'      => $day,
            'compare'  => 'IN',
            'column'   => 'post_date',
        ),
    ),
);容易被忽略的一点:只写 year 是不够的。很多人以为给了年份区间再加 monthnum/day 就”限定在区间内某天”,其实 year BETWEEN 2021 AND 2025 单独使用时,匹配的是这五年里的全部文章,与月日无关。三个维度必须同时给,才能真正表达”往年的今天”。
为什么取 $limit + 2 条?因为后面要剔除”当前正在浏览的这篇文章”:如果只取 limit 条,剔除自己之后就剩 limit−1 条 —— 表现出来就是”列表里只有 4 条,明明设置了 5″。多取 2 条是最省事的余量。
四、死写法③:正确但昂贵 —— 每个访客每次都查一次库
前两个坑修完之后,功能是对的了。但它每次页面浏览都会执行一次 date_query —— 在文章页上这是纯粹的浪费,因为“往年的今天”一天只变一次。
这类”正确但昂贵”的问题不会有任何提示:没有报错、页面不慢到用户能感知、监控图上只是数据库 QPS 高一点。它最容易被留到最后,也最容易在流量上来时变成问题。
缓存键只需要精确到「天」
缓存这件事的第一步是想清楚内容的”变化周期”。「往年的今天」在一天之内是恒定的,跨天才变 —— 所以键里应当有”哪一天”,但不该有”几点几分”:
function my_cache_key($date = '') {
    $date = $date ? $date : current_time('Y-m-d');   // ← 只到「天」
    $sig  = implode('|', array(
        $date,
        (int) MY_YEARS,
        (int) MY_LIMIT,
        my_cache_version(),
    ));
    return 'my_tm_' . substr(md5($sig), 0, 24);
}
两种常见写反的方式:
| 写错的方向 | 后果 |
|---|---|
| 键里完全没有日期 | 跨天后继续发**昨天**的列表,直到 TTL 到期 |
| 键里带上”现在几点” | 每次请求都是新键 → **缓存永远不命中**,等于没加 |
失效用「版本号进键」而不是「枚举删键」
发了新文章、改了文章日期时缓存需要失效。常见的做法是记住所有键名再逐个删除 —— 这需要额外维护一份键清单,漏删一个就静默失效。更简单的做法是让版本号参与键名:
function my_cache_version() {
    $v = get_option('my_tm_cache_v');
    if (!$v) {
        $v = (string) microtime(true);
        update_option('my_tm_cache_v', $v, false);
    }
    return (string) $v;
}

function my_flush_cache() {
    update_option('my_tm_cache_v', (string) microtime(true), false);
    // 旧键自然读不到了,到期后由 transient 自己回收
}
改动版本号 → 所有键同时变化 → 旧缓存立刻读不到。没有需要维护的键清单,也就没有”漏删”这个失效路径。
另外 fields => 'ids' 也值得一加 —— 列表只需要 ID 和标题,不必把整行 post 对象取回来,再配合 no_found_rows(不执行 COUNT)、update_post_meta_cache = false、update_post_term_cache = false(不预热 meta / term),一次查询的开销能小一大截。
五、单测抓出来的两个时区坑(这部分才是意外收获)
上面三个坑是我写代码时就意识到的。下面两个不是 —— 它们是把交付件拉出来做离线单测时,被断言抓出来的。两个都属于同一个根因,而且都很隐蔽,我单独用一节记下来。
根因:WordPress 把 PHP 时区强制设成了 UTC
这是整件事的前提,也是最反直觉的一点:站点的时区不在 PHP 里。WordPress 启动时会执行:
// wp-settings.php
date_default_timezone_set('UTC');
而站点自己的时区(「设置 → 常规 → 时区」)只体现在 current_time() 与 get_option('gmt_offset') 里。于是同一个”现在”,有两个互不一致的读法:
| 读法 | 返回 | 时区语义 |
|---|---|---|
current_time('Y-m-d') | “2026-10-10” | **站点时区**的今天 |
date('j', $ts) | 9 | **UTC** 的日 |
gmdate('j', $ts) | 9 | 同上(UTC) |
在 UTC+8 的站点上,这个差值就是 8 小时 —— 而 8 小时足以跨越一整个日期。
坑 A:每天凌晨,功能列表的是「昨天」的文章
第一个 bug 出在”把日期拆成月/日喂给 date_query“这一步。我当时的写法是:
// ❌ 用 gmdate 从「站点日期」里读月/日
$date  = current_time('Y-m-d');        // 站点时区的今天
$ts    = strtotime($date);
$month = (int) gmdate('n', $ts);       // ← 读的是 UTC 的月
$day   = (int) gmdate('j', $ts);       // ← 读的是 UTC 的日
推演一下 UTC+8 站点在本地 10-10 凌晨 01:00 时的情形:
站点本地      2026-10-10 01:00
对应 UTC      2026-10-09 17:00     ← 跨天了
current_time('Y-m-d')  → "2026-10-10"     (站点语义,正确)
strtotime("2026-10-10") → UTC 10-10 00:00
gmdate('j', 该时间戳) → 10 (这一步本身没问题)问题不在这几行,而在它们与真实”现在”的关系:当站点本地是 10-10 凌晨时,UTC 还是 10-09。于是这段代码算出来的”今天”与 current_time() 认定的”今天”在本地 00:00 到 08:00 这八小时里是不一致的 —— 功能会一直列昨天的文章,到早上 8 点之后”自动就对了”。
这类 bug 的排查体验非常糟糕:
早上测是错的,下午测是对的。你改了一圈代码,下午一验证”好了”,于是以为修好了;第二天早上再看,又错了。—— 一个”随时间变化”的 bug,最容易被误判成”数据不稳定”。
坑 A 的正确做法:链条必须自洽
正确的思路是:输入的日期字符串和解析后的时间戳,必须在同一个时区语义下。current_time('Y-m-d') 给的是站点时区的日期,那就把它当成一个”墙上时间”来解析,再用同样语义的函数读回:
// ✅ 自洽的链条
$date  = current_time('Y-m-d');       // "2026-10-10"(站点时区)
$ts    = strtotime($date);            // 当作 UTC 墙上时间解析
$month = (int) gmdate('n', $ts);      // 10  ← 读回来还是同一个值
$day = (int) gmdate('j', $ts); // 10 ← 与站点日历一致为什么这样是对的:date_query 里的月/日是在数据库里与 post_date 比较的,而 post_date 存的是站点时区的墙上时间。所以喂进去的”10/10″必须来自站点时区的日期 —— 正好是 current_time() 给的那个。链条从头到尾闭合。
要特别避免的反面写法:
// ❌ 这个更隐蔽:current_time('timestamp') 已经被偏移过了
$ts = current_time('timestamp');
date('j', $ts);      // ← PHP 在 UTC 下解读一个"已经 +8h"的值 → 双重错位
gmdate('j', $ts); // ← 换成 gmdate 也不行,因为输入本身就是错的怎么验:别只测”现在”。把站点时钟分别设到本地 01:00 和 23:00,两次的列表必须完全一致。凌晨那一次是唯一能暴露这个坑的时机 —— 而绝大多数人不会在凌晨测。
坑 B:缓存寿命在 24~32 小时之间随机漂移
第二个 bug 是同一个根因的另一副面孔,藏在 TTL 计算里。我原本的写法是”缓存活到明天 0 点”:
// ❌ 看起来两边都是时间戳,其实混了两种语义
function my_ttl() {
    $tomorrow = strtotime( current_time('Y-m-d') . ' 00:00:00 +1 day' );
    $ttl      = $tomorrow - time();
    if ($ttl < 60) { $ttl = 60; }
    return (int) $ttl + HOUR_IN_SECONDS;
}
它看起来没有任何问题 —— “strtotime() 返回时间戳,time() 返回时间戳,两个时间戳相减”。但这两个时间戳不是同一个时区语义:
strtotime("2026-10-10 00:00:00")→ 解析为 **UTC** 的 10-10 零点- 而那个 “2026-10-10” 是
current_time()给的 **站点时区** 日期 time()→ 真实 **UTC** 当下- → 于是”站点日期”携带的 8 小时偏移被混进了减法里
实测算出来的结果是 31.8 小时,而且它不是一个固定值 —— 会随「当前时刻」在 24~32 小时之间漂移:
站点本地 01:10  → UTC 10-08 17:10
strtotime("站点 10-10 00:00:00") = UTC 10-10 00:00
TTL = (UTC 10-10 00:00) − (UTC 10-08 17:10) + 1h = 31.8 小时 ← 多出近一天后果不是致命的(缓存活得久一点),但它是错的,而且会掩盖”谁先到期”的判断 —— 当缓存寿命和别的时效机制(比如 nonce 的轮换窗口)互相牵制时,一个漂移的 TTL 会让你对”余量够不够”的分析完全失准。
坑 B 的正确做法:用站点时区感知的 API
WordPress 5.3+ 提供了 current_datetime(),它返回一个带站点时区的 DateTimeImmutable。用它算出”站点明天 0 点”的绝对时间戳,再与 time() 相减,两边就都是绝对时间了:
function my_ttl() {
    $now_ts = time();

    if (function_exists('current_datetime')) {
        $dt = current_datetime();            // 站点时区下的现在
        $dt = $dt->setTime(0, 0, 0);        // 站点今天 0 点
        $dt = $dt->modify('+1 day');        // 站点明天 0 点
        $ttl = (int) $dt->format('U') - $now_ts + HOUR_IN_SECONDS;
        return (int) max(60, $ttl);
    }

    // 回落:用站点偏移手工换算(低版本 WordPress)
    $offset = (float) get_option('gmt_offset', 0) * HOUR_IN_SECONDS;
    $local  = $now_ts + (int) $offset;
    $mid    = (int) floor(($local + 86400) / 86400) * 86400;
    $ttl    = ($mid - (int) $offset) - $now_ts + HOUR_IN_SECONDS;
    if ($ttl < 60 || $ttl > 30 * HOUR_IN_SECONDS) {
        $ttl = 6 * HOUR_IN_SECONDS;          // 配置异常时退化
    }
    return (int) $ttl;
}
修好之后,在任何时刻计算出来的 TTL 都是「距站点明天 0 点 + 1 小时余量」:站点本地 1 点时约 24 小时、12 点时约 13 小时、23 点时约 2 小时 —— 这才是”对齐内容变化周期”该有的样子。我后来专门用一个子进程把这个曲线测了一遍(见第七节)。
这两个坑的共同教训是:在 WordPress 里,”时间戳相减”并不自动等于”算对了时间差”。只要有
current_time()或者日期字符串参与,就必须问一句——这条链上的每一环,用的是站点时区还是 UTC?
七、验证方法:124 项离线单测,以及”怎么让桩说真话”
这份交付件带一套完全不依赖 WordPress的离线单测(124 项断言全绿):把 WP 函数桩掉,直接 require 交付文件本身,然后断言。它跑起来只要几百毫秒,可以每次改完就跑。
其中最关键的设计是 get_posts() 的桩必须忠实还原 date_query 的语义 —— 如果桩只是”原样返回所有文章”,那么坑②(先取 N 条再过滤)就永远测不出来。所以桩里真的按 year / monthnum / day 去筛:
// 桩:只在下推了 year+monthnum+day 时才筛选
$has_pushdown = $years && $month && $day;
foreach ($all_posts as $id => $p) {
    if ($has_pushdown) {
        $y = (int) substr($p->post_date, 0, 4);
        $m = (int) substr($p->post_date, 5, 2);
        $d = (int) substr($p->post_date, 8, 2);
        if (!in_array($y, $years, true)) { continue; }
        if ($m !== $month || $d !== $day) { continue; }
    }
    $matched[] = $id;   // 没有下推 → 全部通过(这正是错误写法的真实行为)
}这样就能写出反面论证:喂给错误写法 limit=1,断言它筛出 0 条;同时断言正确写法能返回 4 条。”有数据但查不到”这件事,就这样被固化成了回归测试。
★ 关于”缓存是否生效”,断言”调用次数”而不是”结果相等”
这是我这次改对的一个断言口径。测缓存最容易写成这样:
// ❌ 这个断言证明不了任何事情
$a = my_cached_ids();
$b = my_cached_ids();
assert($a === $b); // 两次都查库也会相等!正确的判据是数据库被调用了多少次:
// ✅ 只有「第二次没再查库」才叫缓存生效
$GLOBALS['query_n'] = 0;
my_cached_ids();
assert($GLOBALS['query_n'] === 1);   // 首次:查 1 次
my_cached_ids();
assert($GLOBALS['query_n'] === 1);   // 再次:**仍然只有 1 次**

// 反向:换一天必须各查一次(证明不同日期没串键)
my_cached_ids('2026-10-08');
assert($GLOBALS['query_n'] === 2);
同一类口径问题还有一处值得记:验证”标题被转义”时,我一开始写的是 assert(strpos($html, 'onerror=') === false) —— 它失败了,但代码其实是对的。因为 esc_html() 会把 < 和 " 转义,但不会删掉 onerror= 这几个字母,文字形式的 “onerror=” 会原样留在转义后的文本里 —— 这正是 HTML 转义的正确行为。
// ❌ 判据错了:转义不会让危险词消失
assert(strpos($html, 'onerror=') === false);
// ✅ 判据:危险字符被转义
assert(strpos($html, '<img src=x') === false); // 标签未被直出
assert(strpos($html, '<img') !== false); // 而是被转义了这和之前在别处踩过的一个坑是同一种错误:把”危险词消失了”当成”安全了”。正确的判据永远是”危险字符被转义”,不是”危险词不见了”。
时区问题怎么测:用子进程,让时钟与站点时区成为唯一源
时区坑没法在主测试进程里测 —— 因为交付件用的是真实的 time(),我注入的”假时钟”它看不见。有效的做法是开一个子进程,在干净的桩里提供真实的 current_datetime() 实现,并断言”站点本地 h 点时 TTL ≈ (24−h)+1 小时”:
// 子进程探针(简化)
date_default_timezone_set('UTC');       // 和 WordPress 一样
function current_datetime() {
    return new DateTimeImmutable('now', new DateTimeZone('Asia/Shanghai'));
}
require 'inc/zdw-timemachine.php';
echo round(zdw_tm_ttl() / 3600, 2);     // 期望 ≈ 24 − 本地小时 + 1
实测(站点本地 1 点,Asia/Shanghai):
LOCAL_HOUR=1
TTL_HOURS=23.81      ← 正确;旧实现会给出 31.8
这一步是整个验证里最有价值的一项 —— 它把”我的代码在 UTC+8 站点上算对了”变成了一个可重复执行的断言,而不是”我在下午跑了一遍看起来是对的”。
附:安装与验证速查
安装(三步)
① 把交付文件放到主题里(例如 inc/timemachine.php)或 wp-content/mu-plugins/;
② 在 functions.php 顶层 require_once 引入 —— 它需要在 init 之前挂钩子;
③ 用短码 [zdw_timemachine] 放进任意页面;想让它自动追加到每篇文章末尾,把文件顶部的 ZDW_TM_AUTO 改成 true。
上线前必验四条(每条都有明确的通过标准)
| 检查 | 通过标准 | 怎么验 |
|---|---|---|
| 自动追加生效 | 文章底部出现列表,且**只出现一次** | 打开一篇文章看 |
| 不会误伤别的区块 | 首页/归档页/相关文章区块里**没有**列表 | 逐个页面看 |
| 凌晨不出错 | 把站点时钟设到本地 **01:00**,列表与 23:00 时**完全一致** | 改系统时间或改测试桩 |
| 缓存真的生效 | 第二次访问**不再查库**(用 Query Monitor 看查询数) | 数 SQL 次数 |
三条边界提醒
① 「N 年前的今天」不要包含今年。窗口是 [今年−N, 今年−1]。含今年的话,你今天刚发的文章会立刻出现在”历史上的今天”里 —— 语义就崩了。
② 日期参数一律走白名单,且非法输入要”回落”而不是”变空”。9999-99-99 能通过正则但 strtotime() 返回 false;如果此时返回空数组,使用者会以为”这天确实没内容”,而不是”我把日期写错了”。静默变空是最难排查的一种失败。
③ 任何”跟日期有关”的功能,都要在凌晨测一次。时区 bug 的特征是”只在某几个小时内错”,而绝大多数人的测试时间都在白天 —— 这就是它能长期潜伏的原因。
📚 zibll 子主题开发实录(共 22 篇) · 系列总目录与阅读路径 →
① 前端性能与加载
② 排版与样式系统
- 用 alt 后缀驱动的 WordPress 密集墙排版:从 float 到 flex-wrap 与纵向叠列
- 当主题模板没有过滤器:把「字数+阅读时间」并进它的 meta 行
- 设计令牌的最小实现:一个颜色变量驱动全站(附阅读进度条)
③ 功能实现与边界
- 一个 81 行的朗读按钮改了三轮:三个静默失效的坑
- 删数据类功能怎么写才不闯祸:一个「删文清附件」的六条边界
- 令牌模型与 lost update:一个只在并发时出现的计数 bug
- 「我填了 1 天,它却按 7 天算」:文章过期提示的四个边界
- 「历史上的今天」为什么永远是空的:三个不报错的死写法,与两个时区坑 (本文)
- 文章系列卡片:一个 PHP 8 致命错误,和三处「不报错但白干」的写法
- 友链申请表单:一次越权写入,和一处「写了但不发」的死角
④ 系统与运维
- 404 监控的四个坑:计数翻倍、键名推导、点路径取值、与「自己看不到数据」
- 评论反垃圾的四个坑:先被自己拦住、节流伪装失败、空内容归属、与「WP 原生背锅」
- 页面缓存一次都没命中:六个静默失效,与一条 nonce 结构性保证
- 维护模式:五个「看起来在工作、其实开了后门」的写法
- WebP 自动转换:三个「上传成功、图片没变」的静默失效
- 安全扫描器:五个「扫了但没扫到」的坑,和一个实测确认的路径逃逸
⑤ 成就与活动系统
暂无评论内容