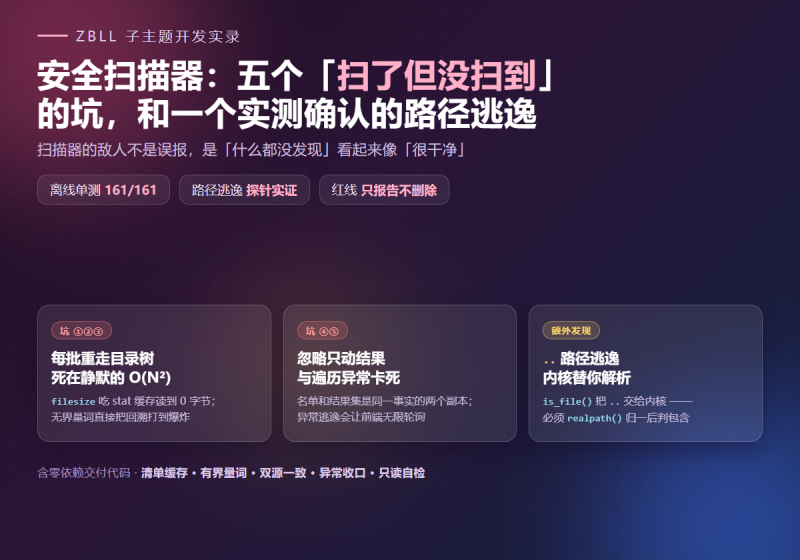
摘要:「扫一遍站点里的 PHP 文件,看看有没有马」—— 需求一句话,实现也不长:遍历目录、读文件、跑几条正则、列个表。但一个能用的安全扫描器和一段能跑的循环之间,差着五个坑,而它们的共同特征又是那句老话:出错时完全不报错。最典型的是第一个 —— 分批扫描接口每批都重跑一次整目录树,总开销从 O(N) 悄悄涨到 O(N²/B);一万个文件批大小 200 时,你会遍历 50 次整棵目录树,每次都 stat 上万个 inode。它的现象不是报错,而是「扫描很慢」,慢到你会以为「本来就该这么慢」。本文拆五个坑,外加一个实测确认的路径逃逸(Linux 上 is_file('../../etc/passwd') 返回 true)。附零依赖交付代码与 161 项离线单测。
一、为什么这类功能特别难发现自己坏了
安全扫描器的验收条件听起来很硬:「扫出已知的问题文件」。但你埋一个测试文件跑一次,看到它出现在结果里 —— 这一次通过什么都证明不了。因为它没验证的东西,恰好是全部难点:
| 你验证了 | 你没验证的 | 失败的后果 |
|---|---|---|
| 「能扫出东西」 | 扫全了吗(遍历有没有漏目录) | 漏掉真正的马窝 |
| 「一次能跑完」 | 扫多少次目录树(O(N²)) | 线上扫一次吃满 CPU,且没人知道为什么慢 |
| 「小文件能扫」 | 0 字节 / 超大文件会怎样 | 读爆内存,或白跑正则 |
| 「规则能命中」 | 规则会不会回溯爆炸 | 单个文件就能卡死一个 PHP-FPM 进程 |
| 「能忽略误报」 | 忽略下次扫描还生效吗 | 误报天天回来,最后你就不看结果了 |
注意第四行的严重性升级:前三行的失败是「没做到」,第四行是「做出了反向效果」——一个设计用来发现危险代码的工具,自己被一段代码拖死了。安全工具的性能边界不是”优化项”,是正确性的一部分。
判断一个扫描器好不好,不要看它能扫出什么,要看它在最坏输入下会做什么。这句话对正则、对目录遍历、对文件读取都成立。
二、坑①:分批接口每批都重跑整目录树(O(N²))
扫描要分批,理由是硬的:PHP-FPM 有 max_execution_time(常是 30 秒),一次扫一万个文件必然超时。所以标准做法是前端循环调用:{ offset: 0, limit: 200 } → { offset: 200, limit: 200 } → …直到后端返回 done: true。
分批本身没问题。问题在批次内部做了什么:
<?php
// ❌ 原始实现(每个批次都这么干)
function zhiji_scan_batch_handler() {
    $offset = (int) $_POST['offset'];
    $limit  = (int) $_POST['limit'];

    $files = zhiji_security_scan_collect_files();   // ← 整棵 themes/plugins/uploads 树
    $batch = array_slice( $files, $offset, $limit );

    foreach ( $batch as $file ) {
        $hits = zhiji_security_scan_file( $file );
        if ( ! empty( $hits ) ) { $result[ $file ] = $hits; }
    }
    set_transient( ZHIJI_SCAN_RESULT_KEY, $result, HOUR_IN_SECONDS );
    wp_send_json( array( 'error' => 0, 'next' => $offset + count( $batch ), 'done' => /* … */ ) );
}
看起来完全正常 —— 每批只扫 limit 个文件,工作量是均摊的。但第一行就不均摊了:collect_files() 每次都重走一遍整棵目录树。
算一下这个账
| 量 | 值 |
|---|---|
| 文件数 N | 10,000 |
| 批大小 B | 200 |
| 批次数 N/B | 50 |
| 每批遍历 | 整棵树一次(含 stat 万个 inode) |
| 总遍历次数 | 50 次(而不是 1 次) |
写成分数就是 O(N²/B) —— 名字里有 N 的平方,而 N 是站点文件数,是一个只会长大的数字。更坏的是它的失败形态:没有任何错误。接口照常返回,进度条照常前进,只是慢。而”慢”在运维里是最容易被合理化的一种异常 —— 你会想「扫全站嘛,慢是应该的」。
如果一个「慢」可以被一句话合理解释掉,那它就会永远留在那里。所以性能问题的第一道防线不是优化,是把它变成一个可以被察觉的信号。
修法:清单进 transient,一次扫描只收集一次
<?php
function zdw_scan_collect_files( $refresh = false ) {
    if ( ! $refresh ) {
        $cached = get_transient( ZDW_SCAN_FILES_KEY );
        if ( is_array( $cached ) ) { return $cached; }   // ★ 一批之后就是 O(1)
    }
    // …遍历、收集、排序…
    set_transient( ZDW_SCAN_FILES_KEY, $files, ZDW_SCAN_FILES_TTL );
    return $files;
}
两个必须一起做的配套动作,漏了任何一个缓存都会出问题:
- 「清空结果」要同时清清单 —— 否则你新增了文件再扫,清单还是旧的,新文件永远扫不到;
- 清单要有 TTL(这里 10 分钟) —— 否则某次扫描之后站点加了插件,用户半小时后再扫仍然用着上一份清单,看不到新插件的文件。
第二点是另一种意义上的”静默失效”:结果不是错的,是不完整的,而且用户无从判断它不完整。
三、坑②:filesize() 的 stat 缓存,和 0 字节的文件
单文件扫描的开头通常长这样:
<?php
// ❌ 原始实现
function zhiji_security_scan_file( $rel ) {
    $path = WP_CONTENT_DIR . '/' . $rel;
    if ( ! is_file( $path ) || filesize( $path ) > 2 * MB_IN_BYTES ) {
        return array();
    }
    $content = @file_get_contents( $path );
    // …跑正则…
}两个问题。第一个是上限判断本身的必要性:file_get_contents() 把整个文件读进内存,然后 8 条正则每条都复制一份内容。一个 200MB 的日志文件(很多人会把 .log 改名成 .php 防下载)足以把 PHP 的内存吃干净 —— 扫描器变成了一个拒绝服务工具。
第二个问题更隐蔽:0 字节的文件也会走到正则那一步。虽然 file_get_contents() 返回空串不致命,但它是白跑 —— 而在一个一万文件的循环里,”白跑 8 条正则 × N” 就是可测量的开销。
⭐ 真正的陷阱:filesize() 走 stat 缓存
这是我在写这一篇的测试时自己踩到的:测试里先写一个 26 字节的小文件,再覆写成 2.8MB 的大文件,然后断言 filesize() > 2MB —— 结果断言失败,报告里显示 [26 B]。
php
# 实测(Windows / PHP 7.4)
file_put_contents($p, '<?php echo 1;');                          // 13 字节
clearstatcache();
$s1 = filesize($p);                                              // 13
file_put_contents($p, '<?php echo 1;' . str_repeat(' ', 5000)); // 5013 字节
$s2_stale = filesize($p);    // ⚠️ 13 —— 读到的是旧值!
clearstatcache(true, $p);
$s2_fresh = filesize($p);    // 5013 —— 清了才对
PHP 会缓存 stat() 系列函数(filesize / filemtime / is_file / file_exists…)的结果,同一个请求内不会重复访问文件系统。这在正常场景下是纯收益 —— 直到你的代码在同一个请求里先改了文件、再问它多大。
对扫描器来说这个场景真实存在:扫描过程中别的进程(或你自己)正在写文件。比如扫描一个日志型 PHP、或者扫描自己刚生成的缓存文件。这时 filesize 给你的可能是几分钟前的大小。
<?php
// ✅ 修法:读大小前,只针对这一个文件清缓存
clearstatcache( true, $path );
$size = (int) @filesize( $path );
if ( $size <= 0 || $size > ZDW_SCAN_MAX_BYTES ) {   // ★ 0 字节也拦掉
    return array();
}
clearstatcache(true, $path) 的第二个参数是只清这一个路径,所以没有"清掉整个缓存导致大量系统调用"的代价。这是全篇最便宜的一个修复:一行,零风险。
四、坑③:正则的两类失效 —— 回溯爆炸与误报洪水
规则集是扫描器的心脏,也是最容易写坏的地方。这里有两类完全不同的失效,而且都很难在测试里被发现。
失效一:无界量词 → 灾难性回溯
检测混淆代码最典型的规则是「base64_decode 后面跟着超长字符串」:
php
// ❌ 原始写法
'gz解压混淆' => '/b(?:gzuncompress|gzinflate|str_rot13|base64_decode)s*(s*[^)]{200,}/i',
//                                                                             ↑↑↑↑↑↑
//                                                                       没有上界!
[^)]{200,} 的意思是「至少 200 个非右括号字符」。直觉上这没问题 —— 超过 200 个就匹配了,能有多慢?
问题在于当匹配失败时正则引擎要做什么。拿一个「有 base64_decode( 但整个文件没有 )」的文件:引擎会尝试从第 200 个字符开始匹配、失败;退一格从第 199 个开始、失败;…一路试到文件开头。这就是灾难性回溯,复杂度从 O(n) 变成 O(n²) 甚至更糟。
我在测试里量了这个差异 —— 用 20 万字节的、故意不带右括号的内容:
| 写法 | 行为 |
|---|---|
[^)]{200,}(无界) | 回溯爆炸:耗时明显更长 / 触发 PREG_BACKTRACK_LIMIT_ERROR |
[^)]{200,4000}(有界) | 迅速返回,无错误 |
注意第二行不是"变快了",而是"从不可控变成可控"。有界的意义是让这条规则的最坏耗时可以被推算:上界 4000 意味着最多检查 4000 个位置,再坏也坏不到哪去。
还有一个必须做的动作:检查回溯错误
光有上界还不够。回溯爆掉时 preg_match() 返回 false,而不是抛异常 —— 如果你不检查,代码会继续往下走,这条规则在这个文件上"没有命中"。
<?php
// ✅ 修法:区分「没命中」和「没跑完」
$m  = array();
$ok = @preg_match( $pattern, $content, $m );
if ( false === $ok ) {
    // 正则本身不合法(配置错误)→ 记日志,别静默跳过
    zdw_scan_log( 'bad_rule', array( 'rule' => $rule, 'err' => preg_last_error() ) );
    continue;
}
if ( PREG_NO_ERROR !== preg_last_error() ) {
    // 回溯超限(PREG_BACKTRACK_LIMIT_ERROR)→ 这是**性能事故的信号**
    zdw_scan_log( 'backtrack', array( 'rule' => $rule, 'file' => $rel, 'err' => preg_last_error() ) );
    continue;
}
preg_match()返回false有两种完全不同的含义:「正则写错了」和「跑到一半放弃了」。两者都不该被当成"没命中"。
失效二:规则命中注释和字符串
/bevals*(/i 这类裸函数名规则,会命中:
- 注释里的
// 不要在这里用 eval( ); - 字符串里的
$doc = "eval( 是危险函数";; - 扫描器自己(对,本文这份代码也会命中它自己 —— 因为它确实包含了
eval(字样)。
这不是 bug,是权衡:要精确判断"这个 eval( 在不在字符串里"需要真正解析 PHP(tokenizer / AST),而那会让扫描器依赖 token_get_all() 或第三方解析器,并且慢一个数量级。对一个只报告不删除的工具来说,宁可误报不可漏报是正确取舍。
但取舍必须说清楚并给出出路,否则用户会对结果失去信任:
- 规则集可被 filter 覆盖 —— 不同站点的误报源不同,硬编码迟早不够用;
- 提供「忽略」名单 —— 确认无问题的文件登记一次,以后不再打扰;
- 界面写明"命中不等于中毒" —— 别让用户看到红字就去删文件。
php
// 站点自己扩规则 / 裁误报:
add_filter( 'zdw_scan_rules', function ( $rules ) {
    $rules['自定义'] = '/MY_DANGEROUS_TAG/';      // 加
    unset( $rules['assert'] );                    // 裁
    return $rules;
} );五、坑④:忽略名单与结果清单是两个数据源
「忽略」这个动作看起来很简单:把文件名加进白名单。但结果清单存在哪里?通常是 transient(因为它是临时数据)。于是就有了两个存储位置:
| 数据 | 存哪 | 生命周期 |
|---|---|---|
| 忽略名单 | update_option() | 持久(用户意图,不该丢) |
| 扫描结果 | set_transient() | 1 小时(临时快照) |
只处理一个会怎样:
<?php
// ❌ 原始实现:只从结果里删掉
function zhiji_scan_ignore_handler() {
    $ignore[] = $file;
    update_option( ZHIJI_SCAN_IGNORE_KEY, $ignore, false );
    $result = get_transient( ZHIJI_SCAN_RESULT_KEY );
    if ( is_array( $result ) ) {
        unset( $result[ $file ] );
        set_transient( ZHIJI_SCAN_RESULT_KEY, $result, HOUR_IN_SECONDS );
    }
    // ⚠️ 下次扫描:结果被重新填充 → 这个文件**又回来了**
    //    但它在 $ignore 里 → 渲染时被过滤 → 表格里看不到
    //    → 于是「忽略了」看起来生效,实则结果集里一直躺着它
}上面的代码表现得像是对的 —— 点忽略,行消失,刷新还在。但它留下了一个隐患:忽略名单会无限增长,而结果集里积累着一堆已被忽略的条目。规模上去之后,每次渲染都要遍历整个结果集再做过滤。
正确的做法是把两者当成一致性的两个副本:
<?php
function zdw_scan_add_ignore( $file ) {
    $file = ltrim( sanitize_text_field( (string) $file ), "/" );
    if ( '' === $file ) {
        return new WP_Error( 'zdw_scan_no_file', '缺少文件参数。' );   // ★ 别把空串写进名单
    }

    // ① 持久源:忽略名单(幂等 —— 重复加不重复入列)
    $ignore = zdw_scan_ignore();
    if ( ! in_array( $file, $ignore, true ) ) {
        $ignore[] = $file;
        update_option( ZDW_SCAN_IGNORE_KEY, $ignore, false );
    }

    // ② 临时源:结果清单(**两个源一起动**,坑④ 的修法)
    $result = get_transient( ZDW_SCAN_RESULT_KEY );
    if ( is_array( $result ) && isset( $result[ $file ] ) ) {
        unset( $result[ $file ] );
        set_transient( ZDW_SCAN_RESULT_KEY, $result, HOUR_IN_SECONDS );
    }
    return array( 'file' => $file, 'ignored' => true, 'ignore_count' => count( $ignore ) );
}
三个容易被忽略的细节:
- 路径归一:客户端可能传
/plugins/a.php(带前导斜杠),不ltrim的话同一文件会存成两条记录,忽略一次不生效; - 幂等:连点两次忽略不该产生两条;
- 空参数要与
WP_Error:静默把空串写进名单,以后每次渲染都要为这个空条目做一次in_array。
六、坑⑤:目录遍历会抛异常 —— 而异常会静默成"卡住"
RecursiveDirectoryIterator 看起来温和,但它在以下情况会抛异常:
- 权限不足的目录(宿主机配错、Docker 卷挂载 uid 不符);
- 坏符号链接(指向已删除目标的软链)—— 这在被入侵过的站点上很常见,因为挂马常留一个指向
/tmp的链; - 路径根本不存在 —— 也是最常见的:用户在设置里勾了一个站点上不存在的目录。
不捕获的话,异常一路冒到 AJAX 分发器 → HTTP 500。而前端的表现是什么?
前端不显示 500。它显示的是进度条停在那里。因为 jQuery 的
$.post收到 500 会走fail分支,而如果你没写 fail 处理器(或者写了但只是不更新状态),页面就会永远停在「扫描中…」——最糟的失败形态:静默卡死,用户不知道该等还是该刷新。
<?php
// ✅ 修法:三重收口
foreach ( zdw_scan_dirs() as $dir ) {
    $base = WP_CONTENT_DIR . '/' . $dir;

    // ① 先判 is_dir **再判 is_readable**:不可读就别进去
    if ( ! is_dir( $base ) || ! is_readable( $base ) ) { continue; }

    try {
        $it = new RecursiveIteratorIterator(
            new RecursiveDirectoryIterator( $base, FilesystemIterator::SKIP_DOTS ),
            RecursiveIteratorIterator::LEAVES_ONLY      // ★ ② 只要叶子,别走目录节点
        );
        foreach ( $it as $file ) { /* … */ }
    } catch ( Throwable $e ) {                        // ★ ③ catch Throwable 而不是 Exception
        // 单个目录失败不影响其它目录
        zdw_scan_log( 'collect_failed', array( 'dir' => $dir, 'msg' => $e->getMessage() ) );
    }
}
为什么是 Throwable 而不是 Exception
PHP 7 之后错误分两支:Exception(传统异常)和 Error(引擎级错误,比如调用未定义函数、类型错误)。两者共同的父接口是 Throwable。只 catch Exception 意味着任何 Error 都会漏过去 —— 而目录遍历抛的 UnexpectedValueException 恰好是 Exception 支,所以这个具体的坑能 catch 住;但既然要写 catch,就该把范围写对,不然下一个坑会从 E 支漏出去。
顺带一个从坑① 延伸出来的防御:缓存丢失时 offset 会越界。
php
# 场景:清单缓存过期(TTL 到了),但前端还拿着上一轮的 offset
# 原始实现:$batch = array_slice($files, 999999, 200) → 空数组
#          → next = offset + 0 = 而 offset 不动 → done = false → 无限循环

# ✅ 修法:显式判越界,直接返回 done=true(并带 stale 标记便于排查)
if ( $offset > count( $files ) ) {
    return array( 'scanned' => 0, 'next' => 0, 'total' => count( $files ),
                  'done' => true, 'hits' => 0, 'stale' => true );
}七、额外发现:一个实测确认的路径逃逸
这一条不在原计划里,是单测在 Linux 上跑出 1 个 FAIL 之后挖出来的。当时我以为是断言写错了(前几张卡十有八九是),结果探针跑出来是真问题。
单文件扫描的入口接收一个相对路径,然后拼成绝对路径:
php
$rel  = ltrim( (string) $rel, "/" );
$path = WP_CONTENT_DIR . '/' . $rel;
if ( ! is_file( $path ) || ! is_readable( $path ) ) { return array(); }
看起来有 ltrim 防住了前导斜杠,也就防住了绝对路径。但 .. 呢?实测:
sql
-- 在 Linux 上实测
拼接后 = /tmp/probe_esc/../../etc/passwd
is_file  = true                  ← ⚠️ 内核解析了 ..
realpath = '/etc/passwd'          ← ⚠️ 归一到真实路径
WP_CONTENT_DIR realpath = /tmp/probe_esc
is_file() 把路径交给内核解析,内核当然认识 ..。所以只判 is_file 的话,传 ../../etc/passwd 就能让扫描器把 /etc/passwd 读进内存,再逐条跑 8 条正则。
严重性要说清楚:这个文件当前没有把客户端传入的 file 参数喂进 scan_file()(忽略接口只把它写进名单),所以不是一条现成可利用的洞。但它是一个错误的设计前提:「扫描器读什么」应当由扫描器自己决定,不能依赖调用方自觉。一旦以后有人加个"单独扫描某个文件"的功能,洞就出现了。
修法:realpath() 归一后做容器检查
<?php
$real = realpath( $path );
$root = realpath( WP_CONTENT_DIR );        // ★ 根也要归一,否则软链下会误判
if ( false === $real || false === $root ) { return array(); }

$root = rtrim( str_replace( '', '/', $root ), '/' );
$real = str_replace( '', '/', $real );

// 必须在 root 之内(自身或 root/ 前缀)
if ( $real !== $root && 0 !== strpos( $real, $root . '/' ) ) {
    zdw_scan_log( 'path_escape', array( 'rel' => $rel, 'real' => $real ) );   // ★ 可审计
    return array();
}
三个细节:
realpath(WP_CONTENT_DIR)必须也取一次 —— 否则站点用软链(wp-content→/data/wp-content)时,两者的字符串形式不同,合法文件也会被全部拦掉;- 比字符串要大小写不敏感(Windows):这里统一把反斜杠换成斜杠,实际生产应配合
DIRECTORY_SEPARATOR与大小写归一; - 拦下来要记日志:逃逸尝试本身是有价值的安全信号 —— 正常用户不会传
..。
写这个修法时最大的收获不是"要防
..",而是「我以为一个断言写错了,结果查出来是代码错了」。前几篇里这种 FAIL 十次有九次是我的断言问题 —— 但正因为每次都用探针去查清真实字节而不是"猜着改断言",这第十次才能被发现。
八、还有一条不能忘的红线:只报告不删除
扫描器扫出可疑文件之后,最"顺理成章"的下一步功能是自动隔离 / 删除。我的实现里刻意没有这个功能,而且把理由写在了后台界面上。
理由不是保守,是三条具体的:
- 误报率不可控:缓存插件、压缩插件、自写工具文件、本文这份代码自己,都会命中
eval(; - 变种无穷:能被 8 条正则识别的马是"笨马"。真正的后门会绕开所有固定规则,而它长得最像正常代码;
- 误判代价不可逆:删掉一个插件文件,站点当场白屏;而这时候你正需要站点活着去排查问题。这种"在最需要救援的时刻把站点弄坏"的失败模式,是运维事故的经典剧本。
所以这份实现的处置链条是:报告 → 人工确认 → 人工处置,中间只提供「忽略」(登记白名单,作用是减少噪音,不是处置)。单测里专门有 3 条断言,扫源码确认没有任何 unlink() / wp_delete_file() / rename()。
php
# 单测里的红线断言(先剥注释,否则「只报告不删除」这句注释自己会误伤)
$SRC_CODE = preg_replace( '#/*.*?*/#s', '', $SRC );
$SRC_CODE = preg_replace( '#^[ t]*//.*$#m', '', $SRC_CODE );

nhas( $SRC_CODE, 'unlink(',       '★★ 代码里没有 unlink(' );
nhas( $SRC_CODE, 'wp_delete_file', '★★ 代码里没有 wp_delete_file' );
nhas( $SRC_CODE, 'rename(',       '★★ 代码里没有 rename(不做隔离式处置)' );

# ★ 对照断言:证明上面「剥注释」这一步有意义(原文里确实有「删除」字样)
has( $SRC, '只报告不删除', '★★ 原源码含「只报告不删除」文案' );最后那条对照断言是我这几篇下来最重要的习惯:断言"代码里没有 X"时,必须同时证明"如果 X 存在,我的断言会失败"。否则一个永远为真的断言(比如把小写写成大写)会给你虚假的安全感。
九、交付代码(公开引导)
下面这份是零依赖单文件版本 —— 只依赖 WordPress 核心函数(get_option / get_transient / add_management_page 等),不依赖任何插件、主题框架或第三方库。
| 项 | 值 |
|---|---|
| 文件 | zdw-security-scan.php |
| 行数 | 约 640 行(含 30% 注释) |
| 函数 | 12 个,全部 zdw_scan_ 前缀 |
| 常量 | 6 个,全部带 defined() 守卫 |
| 挂载 | template_redirect(自检, pri 1) + admin_menu |
| 自检 | ?zdw_scan_check=1(严格只读,manage_options) |
| 测试 | 161 项离线单测(无 WP 环境,PHP 7.4 / 8.0) |
后台页在 工具 → 安全扫描,包含环境信息、扫描按钮、结果表(含命中片段)、忽略名单区块。
十一、验证:161 项离线单测(公开)
单测不依赖 WordPress —— 用桩函数模拟 WP,在纯 CLI 下跑。这样它既能本地跑,也能在服务器上以真实运行身份(www)跑,而后者能抓到一类本地测不出的问题(权限、身份、路径)。
| 节 | 覆盖内容 |
|---|---|
| 一 | 12 个函数定义齐全 |
| 二 | 开关严格读取(8 种取值,含 ' 1 ' 不被 trim) |
| 三 | 目录白名单:7 组脏数据,防 ../ 逃逸 |
| 四 | 规则集:合法性 / 8 条都能命中 / 正常代码零误报 / 有界量词 + 回溯压力测试 |
| 五 | 坑①:清单缓存命中 + refresh 对照 + 分批只收集一次 |
| 六 | 坑②:0 字节 / 超上限 / stat 缓存实证 |
| 七 | 分批:offset 越界 / limit 上下界 / 负数 |
| 八 | 坑④:双数据源一致性 / 幂等 / 空参数 / 路径归一 |
| 九 | 日志节流(子进程:3 次同 key → 只触发 2 次) |
| 十 | 后台页:403 守卫 / 转义 / 多区块断言限定 tbody |
| 十一 | 坑⑤:坏软链 / Throwable / LEAVES_ONLY |
| 十二 | 自检:短路 / 403 / exit 哨兵 / 只读 |
| 十三 | 源码级:零依赖 / 常量守卫 / 六坑修法 / 红线(无删除调用) |
实测结果:本地 PHP 7.4 → 161/161;VM PHP 8.0 以 yuge → 161/161;VM PHP 8.0 以 www → 161/161。
写测试时我自己踩的两个坑(值得记)
gmdate()是 PHP 内建函数,不能redeclare—— 我在桩里定义了它,得到Fatal error: Cannot redeclare gmdate(),子进程输出为空(又双叒是静默失败)。这是本项目第 4 次踩内建函数重名(前 3 次都是header())。- 清理临时目录时
glob('*.php')抓不到非 php 文件 —— 我在子进程目录里写了个status.txt(用来记录status_header()的入参,因为exit之后的打印拿不到),清理时只删了*.php,rmdir失败。
十二、速查表
| 坑 | 现象 | 根因 | 修法 |
|---|---|---|---|
| ① O(N²) 遍历 | 扫描"很慢"(无报错) | 每批都重跑整目录树 | 清单进 transient,一次扫描只收集一次 |
| ② stat 缓存 | filesize 返回旧值 | PHP 缓存 stat() | clearstatcache(true, $path) |
| ② 0 字节 | 白跑 8 条正则 | 只判了上限 | $size <= 0 也拦掉 |
| ③ 回溯爆炸 | 单文件卡死进程 | 无界量词 {200,} | 量词加上界 + 检查 preg_last_error() |
| ③ 误报洪水 | 结果没人看 | 裸函数名规则命中注释/字符串 | 规则可 filter + 忽略名单 + 界面写明 |
| ④ 双数据源 | 忽略"复活" | 只动结果、没动名单(或反之) | 两个源一起动 + 幂等 + 路径归一 |
| ⑤ 遍历异常 | 进度条卡住 | 未捕获异常 → AJAX 500 | catch (Throwable) + is_readable |
| ⑤ 越界 | 扫描永不结束 | 清单过期但 offset 不动 | 显式判越界 → done=true |
| ⚠️ 路径逃逸 | 读站点外文件 | is_file 把 .. 交给内核 | realpath 归一 + 容器检查 |
附:四个可迁移的结论
1. 性能边界是正确性的一部分。这一个模块里,O(N²) 遍历和灾难性回溯都不会报错 —— 它们只是"慢"。而"慢"在没有对照的情况下会被合理化成"本来就该这么慢"。对任何会被用户反复触发的功能,都要问一句「最坏输入下它的复杂度是多少」。
2. 断言要证明「它会失败」。这一篇里我写了大量对照断言:证明缓存确实短路(refresh=true 会重新遍历)、证明无界量词确实更慢、证明剥注释这一步有意义(原文里确实有那个词)、证明容器检查没误杀合法文件。没有对照的断言,你不知道它是否只是恒真。
3. 「两个数据源」是持久化设计的默认陷阱。只要同一个逻辑概念被存在两个地方(持久 option + 临时 transient、缓存 + 源数据、索引 + 实体),就一定会有只更新其中一个的代码路径,而且它当场看起来是对的。写完这种代码,问一句:「另一个源呢?」
4. 每次失败都先查真实字节,不要猜。这一篇的路径逃逸是第 10 次遇到"单测 FAIL"的场合 —— 前 9 次九成是我的断言写错了(needle 带引号、空格不匹配、注释误伤、断言范围超过事实范围、内核重名……)。正因为我每次都写个小探针去打印真实字节而不是"猜着改断言",这第 10 次才能区分出"是我错了"还是"代码错了"。猜着改断言,会把真 bug 一起改没。
📚 zibll 子主题开发实录(共 22 篇) · 系列总目录与阅读路径 →
① 前端性能与加载
② 排版与样式系统
- 用 alt 后缀驱动的 WordPress 密集墙排版:从 float 到 flex-wrap 与纵向叠列
- 当主题模板没有过滤器:把「字数+阅读时间」并进它的 meta 行
- 设计令牌的最小实现:一个颜色变量驱动全站(附阅读进度条)
③ 功能实现与边界
- 一个 81 行的朗读按钮改了三轮:三个静默失效的坑
- 删数据类功能怎么写才不闯祸:一个「删文清附件」的六条边界
- 令牌模型与 lost update:一个只在并发时出现的计数 bug
- 「我填了 1 天,它却按 7 天算」:文章过期提示的四个边界
- 「历史上的今天」为什么永远是空的:三个不报错的死写法,与两个时区坑
- 文章系列卡片:一个 PHP 8 致命错误,和三处「不报错但白干」的写法
- 友链申请表单:一次越权写入,和一处「写了但不发」的死角
④ 系统与运维
- 404 监控的四个坑:计数翻倍、键名推导、点路径取值、与「自己看不到数据」
- 评论反垃圾的四个坑:先被自己拦住、节流伪装失败、空内容归属、与「WP 原生背锅」
- 页面缓存一次都没命中:六个静默失效,与一条 nonce 结构性保证
- 维护模式:五个「看起来在工作、其实开了后门」的写法
- WebP 自动转换:三个「上传成功、图片没变」的静默失效
- 安全扫描器:五个「扫了但没扫到」的坑,和一个实测确认的路径逃逸 (本文)
⑤ 成就与活动系统
暂无评论内容