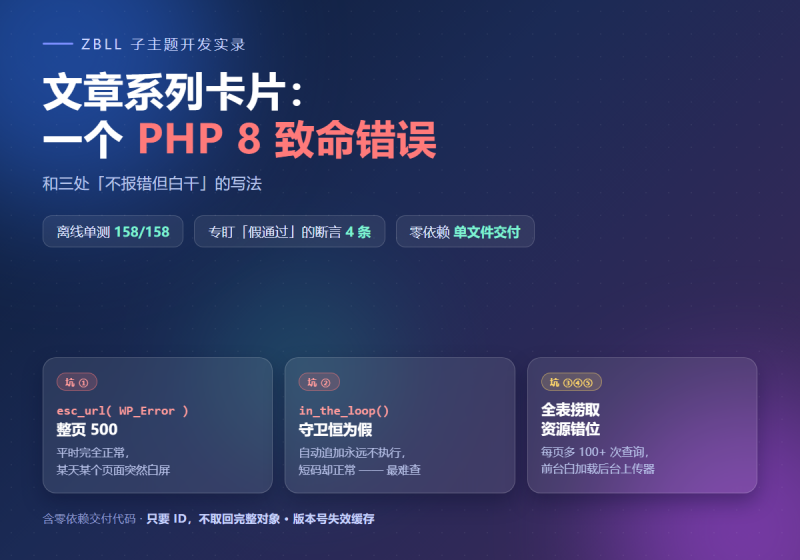
摘要:给文章加「系列连载」导航,核心就三步:注册分类法、查同系列文章、在正文里插卡片。功能很小,但一份「能跑」的实现里通常埋着五个坑,而且五个都不报错:一个平时完全正常、某一天某个页面突然整页 500(PHP 8 的 WP_Error 致命),另一个让「自动追加」永远不执行(in_the_loop() 是恒假的守卫),剩下三个只是让服务器白干活。本文逐条拆开,附零依赖交付代码与 158 项离线单测。
一、需求本身只有三步
把同一专题的多篇文章串起来,正文里显示一张卡片:系列名、封面、第 X / N 篇、上一篇、下一篇、系列目录。实现思路也就三步:
- 注册一个
series分类法 —— 用分类法而不是自定义字段,因为「系列」本质上就是一个多对多的分类关系,白拿后台 UI、归档页、REST 支持; - 查同系列的文章,算出当前文章在这条序列里的位置;
- 在
the_content上插卡片,位置取决于「放正文前还是正文后」。
下面这份实现「能跑」。但它埋了五个问题,五个都不会报错:一个平时完全正常、某一天某个页面突然白屏;一个功能悄悄不生效;另外三个只是让服务器白干活。
「不报错」是这类 bug 最贵的地方 —— 没有错误日志、没有异常栈,只有「感觉哪里不对」。
二、坑①:get_term_link() 可能返回 WP_Error
这是五个问题里唯一会真的把站点打挂的一个,所以放第一个。看这段写法:
<?php
$term      = $terms[0];
$term_link = get_term_link( $term );   // ← 返回值可能是 WP_Error
?>
<h3 class="series-name">
    <a href="<?php echo esc_url( $term_link ); ?>">
        <?php echo esc_html( $term->name ); ?>
    </a>
</h3>
get_term_link() 的文档里写得很清楚:失败时返回 WP_Error。而 esc_url() 的形参是 string。把一个对象传进去会发生什么?这取决于 PHP 版本,而差别是灾难性的:
| PHP 版本 | 行为 | 后果 |
|---|---|---|
| PHP 7.x | Warning:Object of class WP_Error could not be converted to string | 页面继续渲染,链接变成空或乱码 —— 能忍 |
| PHP 8.x | Error 异常:Object of class WP_Error could not be converted to string | 未捕获 → 整页 500 —— 站点白屏 |
PHP 8 把大量原本只是「警告」的类型错误提升成了致命 Error。所以同一份代码在 PHP 7.4 站点上跑两年无事,迁移到 PHP 8 后突然开始零星白屏 —— 而且只有触发了那个分支的页面才白屏,其它页面一切正常,排查起来非常费劲。
什么情况会让它返回 WP_Error?都很平常:
- 分类法在那一刻没注册(某插件在
init后期把它反注册了,或开关逻辑把它挡掉了); - 词条不存在 / 已被删除,但文章上还挂着旧的 term 缓存;
- 多站点环境下
switch_to_blog()之后拿到的 term 属于另一个站点; - 任何第三方 filter 挂在
term_link上返回了WP_Error。
规律:任何「失败返回 WP_Error」的函数,返回值都不许直接进
esc_url()/esc_attr()/ 字符串拼接。必须先判is_wp_error(),再决定渲染什么。
修复方式不是「让它一定有链接」,而是收口成一个安全取值函数,并让调用方处理「没有链接」这种正常情况:
/** 安全取词条链接 —— 出错就返回空串 */
function zdw_ps_term_link( $term ) {
    if ( ! $term || is_wp_error( $term ) ) {
        return '';
    }
    $link = get_term_link( $term );
    if ( is_wp_error( $link ) || ! is_string( $link ) ) {
        return '';
    }
    return $link;
}
然后在渲染处按「有链接 / 没链接」分两条路:
$link = zdw_ps_term_link( $term );

// 链接取不到 → 渲染纯文本,不渲染空 href 的 <a>
$name_html = ( '' !== $link )
    ? '<a href="' . esc_url( $link ) . '">' . esc_html( $term->name ) . '</a>'
: esc_html( $term->name );这里有个刻意的取舍:链接取不到时不出 <a>,只出纯文本。为什么不干脆不出整张卡片?因为卡片的另一半价值是「让读者知道自己在哪条连载里」,这个信息不依赖链接存在。而一个 href="" 的空链接会让用户点下去跳回当前页 —— 比纯文本更差。
同一份逻辑我在「系列目录」按钮上也这么处理了:链接取不到就整块按钮不渲染,而不是渲染一个点不动的按钮。
三、坑②:为了算「第几篇」,把整张表捞了回来
要算「第 2 / 5 篇」和「上一篇 / 下一篇」,最直观的写法是取回同系列的全部文章:
$series_posts = get_posts( array(
    'post_type'      => 'post',
    'posts_per_page' => -1,          // 全都要
    'orderby'        => 'date',
    'order'          => 'ASC',
    'tax_query'      => array( array(
        'taxonomy' => 'series',
        'field'    => 'term_id',
        'terms'    => $term->term_id,
    ) ),
) );

$current_index = 0;
foreach ( $series_posts as $i => $p ) {
    if ( $p->ID === get_the_ID() ) { $current_index = $i; break; }
}这段代码「没问题」。但它做了三件没必要的事,而且每篇文章页、每个访客、每次浏览都要重做一遍:
| 它在做的事 | 实际需要 |
|---|---|
取回完整 WP_Post 对象(标题、正文、摘要、作者、日期……全量字段) | 只需要一个有序 ID 列表 |
SQL_CALC_FOUND_ROWS 额外查一次总数 | 不需要总数 |
| 预热所有文章的 term 缓存(每篇一次分类查询) | 不需要分类 |
| 预热所有文章的 meta 缓存 | 不需要 meta |
| 完全没缓存 —— 下次浏览再来一遍 | 一个系列的文章列表一天内不会变 |
直接后果:一条 50 篇的连载,每个文章页大概多出 100+ 次查询(term + meta 预热),而卡片真正用到的数据只有三样:有序 ID 序列、相邻两篇的 ID、相邻两篇的标题。
修法是四件事一起做 —— 前三条把工作量砍掉,第四条把结果留住:
$ids = get_posts( array(
    'post_type'              => 'post',
    'post_status'            => 'publish',
    'posts_per_page'         => -1,      // 仍要完整序列(要算第几篇)
    'orderby'                => 'date',
    'order'                  => 'ASC',
    'fields'                 => 'ids',   // ★ 只要 ID,别初始化 WP_Post
    'no_found_rows'          => true,    // ★ 不要总数,省掉 SQL_CALC_FOUND_ROWS
    'ignore_sticky_posts'    => true,
    'update_post_term_cache' => false,   // ★ 不预热分类
    'update_post_meta_cache' => false,   // ★ 不预热 meta
    'tax_query'              => array( array(
        'taxonomy' => 'series',
        'field'    => 'term_id',
        'terms'    => $term_id,
    ) ),
) );
标题怎么办?单独取两次
fields => 'ids' 之后就只剩 ID 了,而卡片上要显示上一篇 / 下一篇的标题。做法是只对那两篇单独调 get_the_title( $id ):
- 相邻两篇最多 2 次调用;
get_the_title()命中 WP 的对象缓存时是零查询(正常浏览路径下,这两篇很可能已经在缓存里了);- 换个角度算账:从「取回 50 个完整对象」变成「1 次 ID 查询 + 最多 2 次标题取值」,而卡片上用户能看见的信息一点没少。
缓存:用版本号,不要用删键
把结果整体塞进 transient。这里的关键设计是用版本号参与键名,而不是「内容变更时去枚举删除旧键」:
function zdw_ps_cache_key( $term_id ) {
    $ver = (string) get_option( 'zdw_ps_cache_v', '0' );
    return 'zdw_ps_ids_' . (int) $term_id . '_' . md5( $ver );
}

function zdw_ps_flush_cache() {
    update_option( 'zdw_ps_cache_v', (string) microtime( true ), false );
}为什么偏爱版本号?因为「枚举删键」有一个必然会踩的坑:你总会漏掉某个键。比如「每个系列一个键」,那新建系列、导入文章、批量改分类、定时发布……每一种变更路径都得记得来删一遍。漏掉一种,缓存就不再失效,而缓存不失效表现为「数据看起来是对的,就是旧的」 —— 这种 bug 用户会先发现,你后知道。
版本号法把「失效」压缩成一次 update_option:改完版本号,所有旧键瞬间变成读不到的死键。挂在哪两个钩子上就够?—— save_post 和 delete_post。理由是:系列归属只能通过保存文章来变更,所以这两个钩子覆盖了全部路径。
最后把纯逻辑抽成函数。这张卡片里唯一有分支的部分就是「当前文章在序列里的位置」,一共四种情形(首篇 / 末篇 / 中间 / 不在序列里),也是边界错误的高发区。抽出来之后不用起 WordPress 就能全测掉:
function zdw_ps_locate( $ids, $post_id ) {
    $ids     = array_map( 'intval', (array) $ids );
    $post_id = (int) $post_id;
    $total   = count( $ids );
    $index   = array_search( $post_id, $ids, true );   // ★ 严格比较

    if ( false === $index ) {
        return array( 'index' => -1, 'total' => $total,
                      'prev' => 0, 'next' => 0, 'found' => false );
    }
    return array(
        'index' => (int) $index,
        'total' => $total,
        'prev'  => ( $index > 0 ) ? (int) $ids[ $index - 1 ] : 0,
        'next'  => ( $index < $total - 1 ) ? (int) $ids[ $index + 1 ] : 0,
        'found' => true,
    );
}
array_search( ..., true )的第三个参数不能省。不严格的比较在 ID 是字符串时会误命中 —— 而 ID 从$_GET、REST 参数、meta 里取出来时经常是字符串"7"而不是整数7。
四、坑③:用 ob_start() + 内联 HTML 拼卡片
很常见的模板写法:ob_start() 开缓冲,然后 ?> 切出去写 HTML,最后 ob_get_clean() 取回字符串。
它能跑,但在「输出一段 HTML 并把样式一起带过去」这个场景下有两个隐患:
- 样式和内容被拆到两个不同的输出点 —— 内联 HTML 里只有结构,CSS 在另一个地方(通常是 footer)。任何「只取内容区」的渲染(REST 响应、编辑器预览、摘要、AJAX 片段)都会拿到一份没有样式的裸 HTML;
ob_start()的缓冲在宿主环境被插件接管时会错位 —— 有些缓存 / 压缩插件会自己开缓冲并提前 flush,你的ob_get_clean()拿到的可能不是自己那段。表现是偶尔串位、偶发性,非常难查。
换成 nowdoc 模板 + 占位符,两个隐患一起消掉:
function zdw_ps_template() {
    return <<<'HTML'
<div class="zdw-ps">
    <div class="zdw-ps__hd">
        __COVER__
        <div class="zdw-ps__info">
            <div class="zdw-ps__label">系列连载</div>
            <h3 class="zdw-ps__name">__NAME__</h3>
            __DESC__
            <div class="zdw-ps__progress">__PROGRESS__</div>
        </div>
    </div>
    __NAV__
</div>
HTML;
}

function zdw_ps_fill( $vars ) {
    $tpl = zdw_ps_template();
    foreach ( (array) $vars as $k => $v ) {
        $tpl = str_replace( '__' . strtoupper( $k ) . '__', (string) $v, $tpl );
    }
    // 任何没被填上的占位符都清掉,绝不把 __XXX__ 漏到页面上
    return preg_replace( '/__[A-Z_]+__/', '', $tpl );
}
两个细节值得单独说:
- nowdoc(
<<<'HTML')不解析$。用 heredoc 的话,卡片内容里一旦出现$(比如价格、模板变量说明)就会被 PHP 当成变量插入 —— 又一类「不报错但输出错了」的问题。nowdoc 从根上免疫; - 用
__占位符__而不是sprintf的%s。因为卡片里本来就可能出现裸%(百分比、折扣、排版),sprintf遇到多余的%会警告或错位,而占位符法对内容完全免疫。
另外,最后那句 preg_replace 是兜底:万一以后加了新占位符但忘了填,结果是把 __XXX__ 从页面上清掉,而不是把内部的占位符名字暴露给用户看。失败时的默认行为要选「安静地少一点东西」,而不是「把内部实现漏出去」。
五、坑④:CSS 塞 footer,后台上传器也塞前台 footer
很多主题有一个 footer_add() 之类的工具函数,用来往页面底部追加一段 HTML —— 把 <style> 和 <script> 塞进去非常顺手。这段代码里有两个方向相反的错误:
错误 A:把「被注入内容的样式」放到了 footer
卡片是通过 the_content 过滤器注入正文的。只要有任何一条路径只取内容区、不取整页,footer 的那段 CSS 就不在里面,卡片立刻变成一堆没有样式的裸元素:
- 文章摘要 / 订阅输出;
- REST API 的
content.rendered; - 区块编辑器的预览;
- 任何「AJAX 加载更多」把新内容追加进现有页面 —— 这种场景你会看到前 10 条有样式、后 10 条没样式。
规则:「输出 HTML 再注入」的样式,必须放在被注入内容自己所在的文档里。对本例来说就是:CSS 跟着卡片一起返回,而不是挂到页面 footer。
实现上用一个 static 保证一个页面里出现多张卡片也只输出一份:
function zdw_ps_style() {
    static $done = false;
    if ( $done ) {
        return '';
    }
    $done = true;
    return '<style id="zdw-ps-css">' . /* …样式… */ '</style>';
}
错误 B:把后台上传器脚本加载到了前台
同一个 footer 函数里还塞着「系列封面上传按钮」的 JS。但问题是:前台根本没有那个上传按钮。
于是你在每个访客的每一次浏览中,加载了一整套 wp.media(连带 media-views、underscore、backbone……),去绑定一个前台永远不存在的点击事件。这是纯粹的浪费 —— 而且它永远不会报错,因为代码本身没坏,只是它的执行条件永远不会满足。
正解是搬到 admin_enqueue_scripts,并且用三个条件把范围收到最小:
function zdw_ps_admin_assets( $hook ) {
    // ① 只在词条列表页 / 词条编辑页
    if ( ! in_array( $hook, array( 'edit-tags.php', 'term.php' ), true ) ) { return; }
    // ② 只在本分类法
    $tax = isset( $_GET['taxonomy'] )
        ? sanitize_key( wp_unslash( $_GET['taxonomy'] ) ) : '';
    if ( 'series' !== $tax ) { return; }
    // ③ 只有能管分类的人
    if ( ! current_user_can( 'manage_categories' ) ) { return; }

    wp_enqueue_media();
    wp_enqueue_script( 'jquery' );
    wp_add_inline_script( 'jquery', /* …上传器… */ );
}
于是前台页面的 footer 里再也不会有这个脚本。这个取舍很划算:后台少一点「顺手」,换来前台每个访客每次浏览都少加载一整套媒体库。
六、坑⑤:in_the_loop() —— 一个看起来最对、实际永远为假的守卫
很多人会这样写自动插入的守卫:
add_filter( 'the_content', function ( $content ) {
    if ( ! in_the_loop() ) {   // 想表达:只在主循环的单篇文章里追加
        return $content;
    }
    return $content . my_card();
} );这段代码的意思看起来毫无歧义。但in_the_loop() 在 the_content 过滤器里恒为 false,上面那张卡片永远不会被追加。原因在它的实现:
function in_the_loop() {
    global $wp_query;
    if ( ! isset( $wp_query ) ) { return false; }
    return $wp_query === $GLOBALS['wp_the_query'];   // ← 比的是 wp_the_query
}
$wp_the_query 只在主循环第一次 the_post() 时被赋值。而 the_content 过滤器一次都不需要 the_post() 提供的循环上下文 —— 主题完全可能在循环外调用 apply_filters( 'the_content', ... )(比如显式取某篇文章的内容)。所以在过滤器里,那个全局量可能根本没有设置,in_the_loop() 直接返回 false。
表现极具误导性:短码正常工作,只有「自动追加」失效。于是你会以为是钩子没挂上、优先级不对、主题没调 the_content……一圈排查下来全是错的方向。
正确的守卫是「当前渲染的文章就是主查询那篇文章」:
$post_id = (int) get_the_ID();
if ( $post_id <= 0 || (int) get_queried_object_id() !== $post_id ) {
    return $content;   // 只处理「主查询的那篇文章」,其它上下文一概不插
}
配合前面的 is_singular( 'post' ),这个条件同时挡住了「归档页摘要」「相关文章列表」「REST 批量取内容」等所有不该插卡片的场景。
八、验证:158 项离线单测,其中 4 条专门盯「假通过」
这份代码配了一份不需要 WordPress 的单元测试 —— 用桩函数模拟 WP 的 API,直接 php _zdw_ps_test.php 就能跑,158 项断言全绿。写这份测试的过程里,有四条断言本身是错的 —— 而它们全都是「看起来通过、实际什么都没验」的类型,比代码 bug 更值得记下来。
假通过 ①:断言参数写反 → 永真式
断言函数签名是 nhas( $needle, $haystack )(haystack 里不该出现 needle)。有两条我写成了 nhas( $source_code, 'ob_start()' ) —— 参数顺序反了。于是断言变成「ob_start() 这个字符串里,不该出现整份 3 万字的源码」—— 永远为真。
一条永远通过的断言,比没有断言更危险:它让你以为自己验过了。写完断言之后,值得反向问一句:「这条断言在什么情况下会失败?」如果答不上来,它大概率是永真式。
假通过 ②:源码检查命中了注释
「源码里不该出现 ob_start()」这条断言确实需要(用它证明坑③真的修掉了)。但直接 strpos() 会命中文件头注释里描述「原本用了 ob_start()」的那句话。
同理还有 in_the_loop():交付代码的注释里专门解释了为什么不用它,于是「代码里不含 in_the_loop()」这条断言必然失败。解法是先剥掉注释再做源码断言:
$code = preg_replace( '#/*.*?*/#s', '', $src );   // 去块注释
$code = preg_replace( '#^s*//.*$#m', '', $code );  // 去行注释

nhas( 'ob_start()', $code, '可执行代码不含 ob_start()' );
nhas( 'in_the_loop()', $code, '可执行代码不含 in_the_loop()' );
假通过 ③:缓存断言比「结果相等」,而不是数「调用次数」
验证缓存最容易写错的断言是「连续查两次,结果一样」。问题是:在一个完全没缓存的实现上,这个断言照样通过 —— 因为数据库里的数据本来就没变。
正确的断言是数查询次数:
$GLOBALS['__calls']['get_posts'] = 0;

$ids1 = zdw_ps_cached_ids( 7 );
$ids2 = zdw_ps_cached_ids( 7 );
$ids3 = zdw_ps_cached_ids( 7 );

eq( 1, $GLOBALS['__calls']['get_posts'], '第二次、第三次都没有新增查询' );配套的还有一条:桩函数必须「忠实」。我最初的 get_posts() 桩只记录参数然后返回固定数组 —— 这种情况下「按 tax_query 过滤」根本没被模拟到,于是任何查询相关的 bug 都测不出来。改成让桩真的按 term 过滤之后才有意义。同理,缓存版本号失效那条断言也不能只比结果:必须断言版本号变化后查询次数 +1。
假通过 ④:XSS 断言「危险词消失了」
我把系列名设成 <img src=x onerror=alert(1)>,然后断言结果里不该出现 onerror= —— 失败。因为 esc_html() 根本不删这几个字母,它转的是引号和尖括号。
正确的断言必须盯着「危险字符是否被转义」,而不是「敏感词是否消失」:
ok( false !== strpos( $html, '<img' ), '尖括号被转义为实体' );
nhas( '<img src=x', $html, '结果里没有裸 <img 标签' );
nhas( '"><script>x</script>', $html, '属性里没有逃逸出来的引号' );
还有一条断言是因为「类名里本来就有双下划线」而假失败:我写了「结果里不该出现 __」(想验证占位符没漏出去),但 BEM 命名的类名 zdw-ps__nav 本身就含 __。正确口径是断言「没有 __大写字母__ 形态的占位符」。这和「判断泄漏要看字节位置、不要看是否存在」是同一个道理:先想清楚「目标特征」长什么样,再断言它。
测试覆盖了什么
| 段 | 覆盖内容 | 关键断言 |
|---|---|---|
| 1 | zdw_ps_locate() 四种分支 | 首篇 / 末篇 / 中间 / 不在序列 / 空序列 / 单篇 / 字符串 ID |
| 2 | nowdoc 模板填充 | 未提供的占位符也被清掉,不留 __XXX__ |
| 3 | zdw_ps_term_link() 收口 | WP_Error → 空串,返回值绝不是对象 |
| 4 | 缓存 | 数查询次数;版本号变化后查询 +1 |
| 5 | 查询参数形态 | fields=ids / no_found_rows / 不预热缓存 |
| 6–7 | 卡片渲染三态 + 单篇 | 第 X / N 篇算对;单篇不出导航区 |
| 8 | WP_Error 路径不致命 | 不抛异常、不出空 href、不出系列链接 |
| 9–10 | 不在序列 / XSS | 危险字符被转义为实体 |
| 11 | the_content 守卫 | 卡片字节位置 < 正文字节位置(位置断言) |
| 12 | 保存封面权限 | 无 manage_categories 时不写入 term meta |
| 13–16 | 后台加载条件 / 自检端点 / 源码卫生 | 页面后缀、taxonomy 参数、权限三重收窄 |
| 17–18 | static 一次性行为 | 放子进程测;render_card() 本身不含 CSS |
两条测试基础设施的坑
① static 状态必须在干净进程里测。我最初把「第一次调用 zdw_ps_style() 应返回 CSS、第二次应返回空」放在主进程里跑 —— 必然失败,因为前面的用例(渲染卡片)早就把 static $done 消费掉了。正确做法是把这段逻辑单独 eval 到一个子进程里跑,只加载目标函数、按真实调用顺序验一遍。
② Windows 的 cmd 不支持 VAR=value cmd 前缀语法。我本想用环境变量给子进程传参数,结果报 'Z' is not recognized。Linux 上的 FOO=1 php x.php 在 Windows 上必须换成 $argv[1] 传参。
附:五处问题的速查表
| 写法 | 表现 | 修法 |
|---|---|---|
esc_url( get_term_link( $term ) ) | PHP 8 整页 500(平时正常,偶发) | 先 is_wp_error() 判,回落空串;链接为空时不出 <a> |
get_posts( [posts_per_page => -1, tax_query] ) | 慢(每页 100+ 次查询),无报错 | fields=ids + no_found_rows + 不预热缓存 + transient 缓存 |
ob_start() + 内联 ?> HTML | 能跑;内容被单独取走时样式缺失;缓冲被插件接管时错位 | nowdoc 模板 + __占位符__ 填充 |
CSS / JS 一律塞进 footer | AJAX 追加的内容没样式;前台白加载后台上传器 | CSS 随卡片返回(static 控一次);上传器搬 admin_enqueue_scripts 并三重收窄 |
在 the_content 里判 in_the_loop() | 自动追加永远不执行,短码却正常(误导性最强) | get_queried_object_id() === get_the_ID() |
五条里只有第一条会真的把站点打挂,另外四条都只是「让服务器白干活」或「功能悄悄不生效」。但排查成本是反过来的:不会报错的问题,最难发现。
📚 zibll 子主题开发实录(共 22 篇) · 系列总目录与阅读路径 →
① 前端性能与加载
② 排版与样式系统
- 用 alt 后缀驱动的 WordPress 密集墙排版:从 float 到 flex-wrap 与纵向叠列
- 当主题模板没有过滤器:把「字数+阅读时间」并进它的 meta 行
- 设计令牌的最小实现:一个颜色变量驱动全站(附阅读进度条)
③ 功能实现与边界
- 一个 81 行的朗读按钮改了三轮:三个静默失效的坑
- 删数据类功能怎么写才不闯祸:一个「删文清附件」的六条边界
- 令牌模型与 lost update:一个只在并发时出现的计数 bug
- 「我填了 1 天,它却按 7 天算」:文章过期提示的四个边界
- 「历史上的今天」为什么永远是空的:三个不报错的死写法,与两个时区坑
- 文章系列卡片:一个 PHP 8 致命错误,和三处「不报错但白干」的写法 (本文)
- 友链申请表单:一次越权写入,和一处「写了但不发」的死角
④ 系统与运维
- 404 监控的四个坑:计数翻倍、键名推导、点路径取值、与「自己看不到数据」
- 评论反垃圾的四个坑:先被自己拦住、节流伪装失败、空内容归属、与「WP 原生背锅」
- 页面缓存一次都没命中:六个静默失效,与一条 nonce 结构性保证
- 维护模式:五个「看起来在工作、其实开了后门」的写法
- WebP 自动转换:三个「上传成功、图片没变」的静默失效
- 安全扫描器:五个「扫了但没扫到」的坑,和一个实测确认的路径逃逸
⑤ 成就与活动系统
暂无评论内容