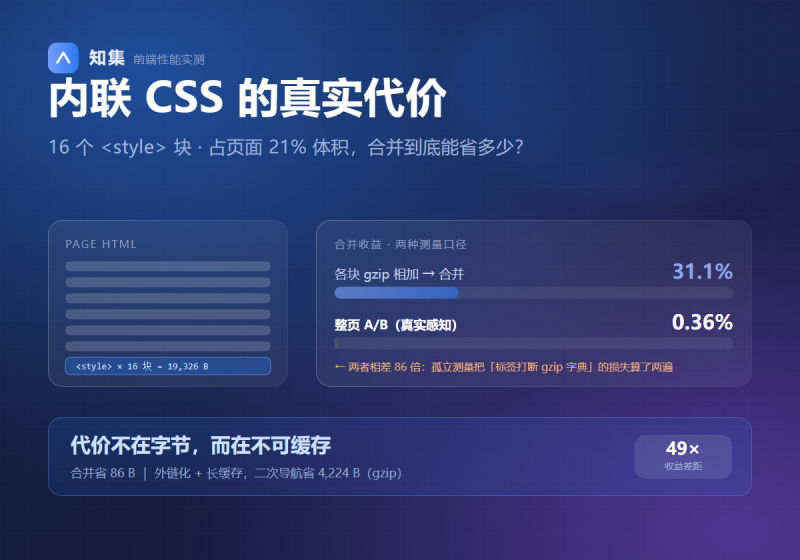
摘要:子主题里功能一多,每个功能都爱往页面里塞一段 <style>:朗读按钮、阅读进度、字数行、图片排版……一篇文章页面上就这样躺着 16 个内联样式块。我早先给过一个「合并后省 25.6%」的数字,本文把它证伪——真实页面上只省 0.36%(86 字节)。更重要的是:内联 CSS 的代价从来不是字节,而是不可缓存;而合并/收集器的真正价值也不是省字节,是把 N 个散点收成一个可以一键切外链、可长缓存的出口。
适合阅读:WordPress 主题 / 插件开发者,以及在意首屏体积与缓存策略的前端。文末附可直接复制使用的零依赖收集器代码与线上实测数据。
一、起因:一篇文章页面上 16 个内联样式块
先看一个真实页面(本站文章页,线上原始 HTML 抓取)的体检结果:
| 页面 | HTML 原始 | HTML gzip | 内联 <style> | 内联合计 | 外链样式表 |
|---|---|---|---|---|---|
| 首页 | 68,441 B | 15,632 B | 6 个 | 15,140 B(占原文 22.1%) | 5 条 |
| 文章页 | 90,440 B | 23,786 B | 16 个 | 19,326 B(占原文 21.4%) | 6 条 |
21% 的页面体积是内联 CSS,这个数字值得警惕。而这 16 个块的来源分三类:
- WP 核心与区块库(11 块 / 17,286 B,占内联总量 89.4%):
global-styles9,335 B、block-library4,274 B,其后是 heading / paragraph / categories 等按需加载的区块样式; - 子主题的功能样式(4 块 / 1,439 B,占 7.4%):阅读进度条 603 B、色彩令牌 445 B、字数行 291 B、图片排版 100 B;
- 还有 1 块 601 B 没有
id属性(父主题输出的)。
看到第 2 条我就该收手了,因为自家功能的全部内联 CSS 只有 1.4KB。但当时我先盯上了「块数」:我有四个功能各写一段 wp_add_inline_style(),页面上就多出四个块,每个块都要占 DOM、都不可缓存。于是我去查合并能省多少——然后拿到一个漂亮的数字:25.6%。
那个数字是错的。而它错的方式,比数字本身更值得写下来。
二、口径陷阱:孤立测量 vs 整页 A/B
2.1 为什么「各块分别 gzip 再相加」会高估收益
gzip 用的是 deflate,本质是 32KB 滑动窗口 + 字典。压缩一段文本时,出现过的字符串会被记进字典,后面再遇到同样的字符串就用很短的引用代替 —— 这就是 CSS 这种高度重复文本能压到 15%~20% 的原因。
问题在于:每个 <style> 标签之间的 HTML 正文,会把窗口占满、把字典冲淡。你如果拿四段 CSS 各自跑一次 gzip 再相加,等于让每段都从零开始建字典,算出来的是「四份孤立文本的压缩后大小」;而用户拿到的是一个已经包含正文的完整页面,CSS 里的重复片段早就被正文覆盖过、或者反过来,边际压缩收益远没有孤立测量那么高。
2.2 正确口径:同一份 HTML 的 A/B 对照
唯一能反映用户真实感知的测法,是控制变量只改「块边界」:
- A 组(现状):原始的完整 HTML,内联块保持 N 个;
- B 组(假设优化):把全部内联块的内容原样抽出,拼成一个
<style>放回原位,其余 HTML 一个字节不动; - 两组各跑一次 gzip,比较总大小。
差别只在标签边界 —— 抽出的 CSS 文本是同一份,顺序也不变,所以省下的字节就是「块边界造成的字典损失」的全部。
三、线上实测:两个口径差了两个数量级
在真实线上页面(HTTP 抓取原始 HTML,不是本地渲染)跑上述两种口径:
| 页面 | 块数 | 内联合计 | 孤立口径 (各块 gzip 相加 → 合并) | 整页 A/B (原页面 → 合并后页面) |
|---|---|---|---|---|
| 首页 | 6 | 15,140 B | 省 14.2%(3,850 → 3,304 B) | 省 0.15%(15,632 → 15,608 B) |
| 文章页 | 16 | 19,326 B | 省 31.1%(6,134 → 4,224 B) | 省 0.36%(23,786 → 23,700 B) |
同一件事,孤立口径说「省 14%~31%,值得做」,整页口径说「省 24~86 字节,等于没做」。差异全部来自口径。我把这组数字记在这里,是因为我确实照着孤立口径的结论去写过「合并能省 25.6%」——如果你也这么测,会得出同样的错误结论。
顺带一个安慰:合并成一块以后,块内 gzip 的确变小了(3,850→3,304 / 6,134→4,224),说明「标签打断字典」这个现象是真实存在的,只是被整页的基数稀释掉了 —— 在纯 CSS 打包场景(把 N 个 css 文件合成一个)里,这个收益依然成立;但在「内联在 HTML 里」的场景,它几乎归零。
四、真正的代价:不可缓存
既然合并省不了字节,那内联 CSS 到底贵在哪?贵在它每次都要重传。
内联样式是 HTML 的一部分,而 HTML 是不可缓存的(或者说缓存极短)。用户从首页点进文章、从文章点回列表,每一次导航都要重新下载这 19.3KB(gzip 4.2KB)的内联 CSS。而外链文件只要不是第一次访问,浏览器要么直接命中内存/磁盘缓存(0 字节),要么发一个条件请求拿到 304(也只有几百字节响应头)。
| 优化手段 | 一次导航省下(gzip) | 二次导航省下(gzip) | 代价 |
|---|---|---|---|
| 合并成 1 个内联块 | 86 B | 86 B | 几乎为零(代码改动) |
| 切换为外链 + 长缓存 | 约 0 B (多一次请求) | 约 4,224 B | 一次额外请求(首访) |
以文章页 19,326 B 内联(gzip 4,224 B)为例:合并能省 86 字节,外链化在二次导航能省 4,224 字节 —— 相差 49 倍。
外链的缓存语义我实测确认过(同一份收集器输出,只用 HTTP 头说话):
HTTP/1.1 200 OK
Content-Type: text/css
Cache-Control: max-age=43200
ETag: "6ac24d15-339"
Last-Modified: Sun, 04 Oct 2026 12:56:53 GMT

# 同一 URL 带 If-None-Match 再请求:
HTTP/1.1 304 Not Modified        ← 命中缓存,0 字节 body
12 小时长缓存 + ETag 条件请求。而内联块的缓存能力是零:它跟 HTML 同生共死,HTML 不缓存,它就不缓存。
五、方案一:空句柄收集器,把 N 个散点收成一个出口
WordPress 有一个很少被提及的机制:src = false 的样式句柄不产生任何 HTTP 请求。利用它可以把多个功能的样式合并进同一个 <style>:
// 1) 注册一个「空句柄」—— src 传 false,不会输出 <link>
wp_register_style('zdw-collector', false, array(), null);
wp_enqueue_style('zdw-collector');

// 2) 各个功能把自己的 CSS 追加到这个句柄上
wp_add_inline_style('zdw-collector', ".zdw-tts{...}");
wp_add_inline_style('zdw-collector', ".zdw-progress{...}");

// 结果:页面上只有 1 个 <style id='zdw-collector-inline-css'>,没有 <link>
5.1 三个必须注意的点(都是静默失败)
- 必须先
register再enqueue:句柄不存在时wp_add_inline_style()直接返回 false 且不报错,样式整块消失; - 入队优先级必须足够晚:
wp_print_styles在优先级 100 执行,而 WP 里同优先级按注册先后执行 —— 你的收集器如果挂在 20,会跑在各功能声明之前,收集到空数组。取 99 最稳(晚于业务声明、早于打印); - 调用时机必须在
wp_enqueue_scripts之前:写在wp_footer里必然无效(那时资源早就打印完了)。
5.2 实测:三态对照
用三段与真实功能同量级的样式(合计 912 B)在线上文章页做对照测试:
| 形态 | 本次测试的 <style> 块 | <link> | 可缓存 |
|---|---|---|---|
① 三个功能各自 wp_add_inline_style(基线) | 3 块 / 912 B | +0 | 否 |
| ② 走收集器 → 合并内联 | 1 块 / 869 B | +0 | 否 |
| ③ 走收集器 + 外链开关 | 0 块 | +1(zdw-collector-css) | 是(max-age=43200 + 304) |
注意 ② 和 ③ 的差别:同样是「消除散点」,② 只是把 N 变成 1(省 DOM 节点、省 0.36% 字节),③ 才是真正把「不可缓存」变成「可缓存」的那一步。收集器的价值是让 ②→③ 只改一个开关。
六、方案二:一键切成可缓存外链
外链化最容易踩的坑是版本号:改了 CSS 用户却看不到,或者反过来每次请求都写一个新文件。正确做法是用内容哈希命名文件:
$hash = substr(md5($css), 0, 8);
$file = $dir . '/collector-' . $hash . '.css';   // 内容变 → 文件名变
if (!file_exists($file)) {
    wp_mkdir_p($dir);
    file_put_contents($file, $css);
    // 只保留最近 3 个版本,避免 uploads 目录堆积
}
wp_enqueue_style('zdw-collector', $url . '/collector-' . $hash . '.css', array(), $hash);
这样做的三个好处:
- 天然长缓存安全:内容一变 URL 就变,不存在「用户拿到旧 CSS」这种问题,可以放心用 12 小时甚至一年;
- 幂等:内容没变就不写盘,一个站点同内容只有一个文件;
- 可降级:目录不可写时自动回退到内联输出,功能不受影响(并在诊断输出里标
fallback)。
七、踩坑记录
整个改造过程我自己踩了 5 个静默失败,全部是「页面能开、只是少了样式」这一最难发现的一类:
| # | 坑 | 现象 | 根因 / 解法 |
|---|---|---|---|
| 1 | 只 wp_add_inline_style 没先 wp_register_style(..., false) | 样式整块消失,无任何报错 | 句柄不存在时该函数静默返回 false。必须先注册空句柄再追加 |
| 2 | 收集器挂在默认优先级 20 | 页面开得起来,但只收集到部分功能(少块) | 同优先级按注册顺序执行 → 收集器跑在功能声明之前。改 99 |
| 3 | 在 wp_footer 里调用收集器 | 完全无输出 | wp_print_styles 在优先级 100 早已执行,之后再入队 WP 静默忽略 |
| 4 | 外链文件名用时间戳 | 每次请求都写新文件,uploads 目录暴涨 | 改用内容哈希命名(内容不变就不写盘) |
| 5 | 临时测试的 mu-plugin 忘了删 | 所有页面都多出测试用的 3 个块 | 测试残留必须清理并在验收里断言「块数回到基线」 |
八、结论与阈值
把结论压缩成一张可以直接照着做的表:
| 场景 | 建议 | 理由 |
|---|---|---|
| 单块 <1KB,且只在特定页面出现 | 内联 | 省一次请求 + 防 FOUC;合并收益可忽略 |
| 累计 >5KB(gzip) 或 块数 >5 | 收进一个收集器 | 少 N-1 个 DOM 节点,且获得「一键外链化」的能力 |
| 累计 >5KB 且全站都需要 | 外链 + 内容哈希长缓存 | 二次导航 0 字节/304,收益是合并的几十倍 |
| 已经是外链的独立文件 | 别再改成内联 | 把可缓存的东西变成不可缓存,是净亏损 |
一句话:内联 CSS 要优化的是「缓存」,不是「字节」。
附:复现本文数据
本文全部数字都可用下面的方法复现,不需要装任何依赖:
Python 3.8+ 标准库即可(urllib + gzip + re 三个模块)

1) 抓页面原始 HTML        → urllib.request.urlopen(url).read()
2) 抽出全部内部联样式       → re.findall(rb'<style[^>]*>(.*?)</style>', html, re.S)
3) 造 B 组:把 N 个块替换成「把 N 段内容拼起来」的 1 个块,其余 HTML 不动
4) 比较 gzip.compress(A, 6) 与 gzip.compress(B, 6) 的字节数
   —— 压缩级别固定为 6,与服务端常见配置一致,避免级别差异污染结论
注意两点:① 一定用整页 A/B,不要用「各块分别压缩再相加」;② 压缩级别要固定,级别不同结果不可比。
📚 zibll 子主题开发实录(共 22 篇) · 系列总目录与阅读路径 →
① 前端性能与加载
② 排版与样式系统
- 用 alt 后缀驱动的 WordPress 密集墙排版:从 float 到 flex-wrap 与纵向叠列
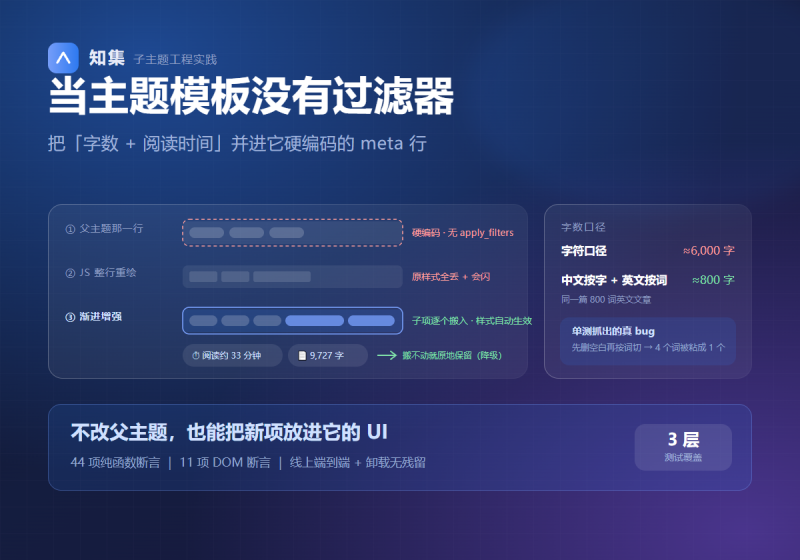
- 当主题模板没有过滤器:把「字数+阅读时间」并进它的 meta 行
- 设计令牌的最小实现:一个颜色变量驱动全站(附阅读进度条)
③ 功能实现与边界
- 一个 81 行的朗读按钮改了三轮:三个静默失效的坑
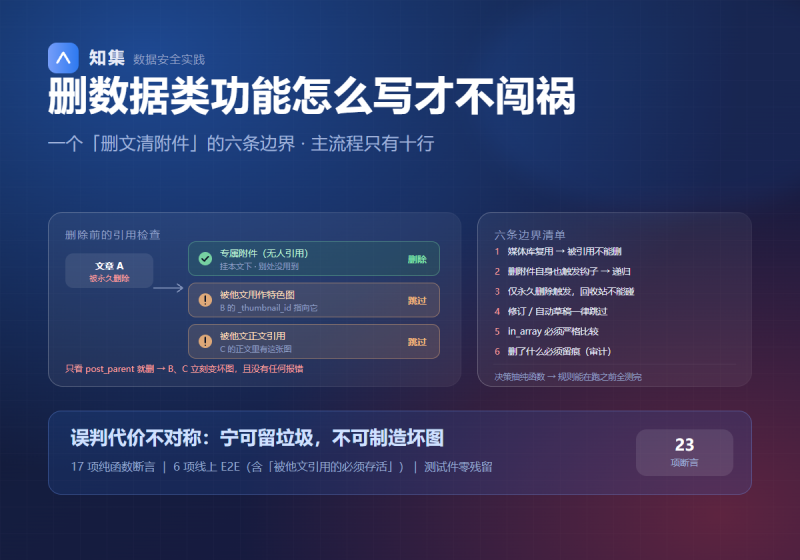
- 删数据类功能怎么写才不闯祸:一个「删文清附件」的六条边界
- 令牌模型与 lost update:一个只在并发时出现的计数 bug
- 「我填了 1 天,它却按 7 天算」:文章过期提示的四个边界
- 「历史上的今天」为什么永远是空的:三个不报错的死写法,与两个时区坑
- 文章系列卡片:一个 PHP 8 致命错误,和三处「不报错但白干」的写法
- 友链申请表单:一次越权写入,和一处「写了但不发」的死角
④ 系统与运维
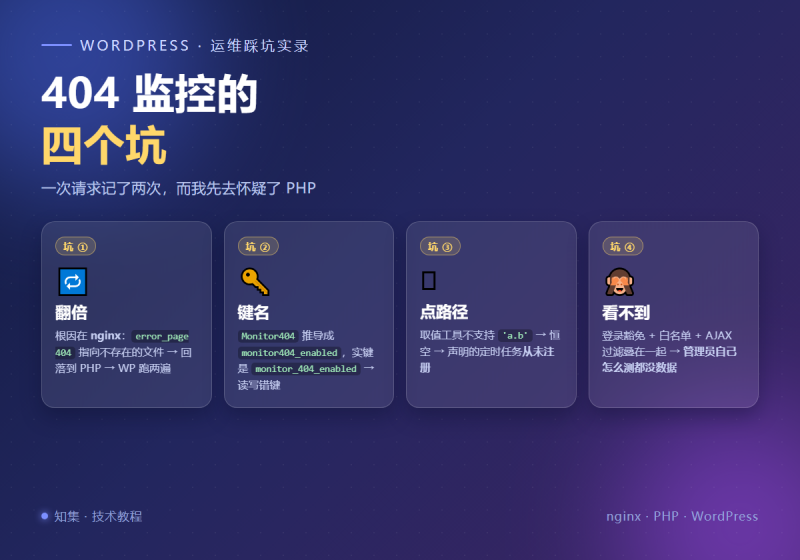
- 404 监控的四个坑:计数翻倍、键名推导、点路径取值、与「自己看不到数据」
- 评论反垃圾的四个坑:先被自己拦住、节流伪装失败、空内容归属、与「WP 原生背锅」
- 页面缓存一次都没命中:六个静默失效,与一条 nonce 结构性保证
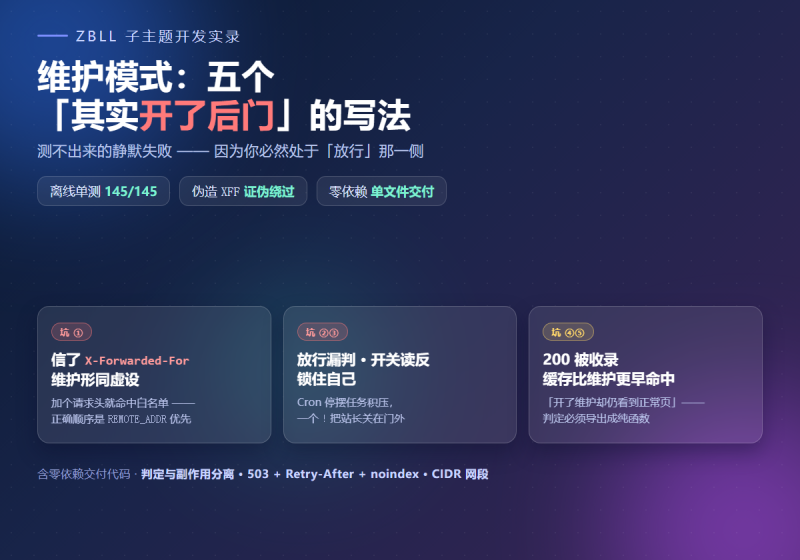
- 维护模式:五个「看起来在工作、其实开了后门」的写法
- WebP 自动转换:三个「上传成功、图片没变」的静默失效
- 安全扫描器:五个「扫了但没扫到」的坑,和一个实测确认的路径逃逸
⑤ 成就与活动系统
暂无评论内容