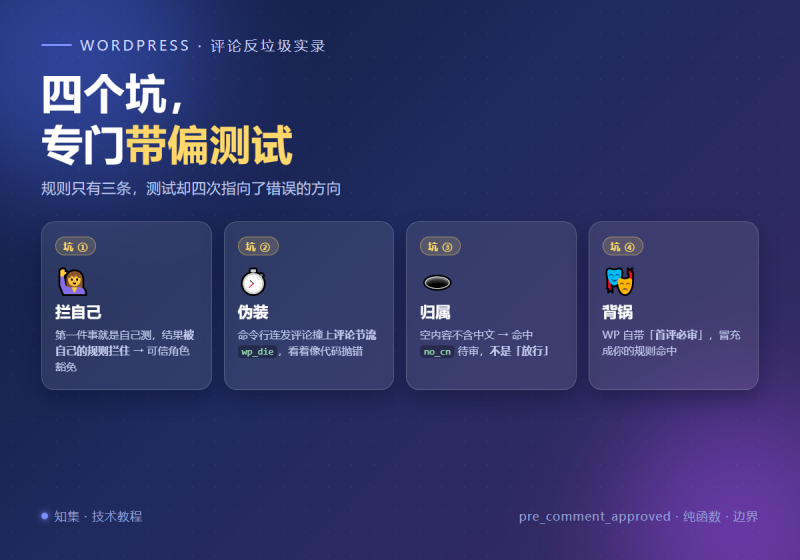
摘要:给站点加了一套评论反垃圾:敏感词、必含中文、最大字数三条规则,命中不拒绝、只转待审核。功能不到 100 行,但从「写完」到「测试全绿」的过程里,有四个坑专门负责把你带偏——管理员自己先被规则拦住、命令行测试撞上评论节流、空内容落在你没想到的那条规则上、以及 WordPress 自带的「首评必审」冒充成你的命中。本文逐一还原,并给出「不用发 HTTP 请求也能测规则」的做法与一份零依赖交付代码。
适合阅读:写过评论/表单类拦截、或正在被「测试结果和预期对不上」困扰的开发者。
一、设计取向:宁可漏,不可误杀
垃圾评论拦截最怕的不是「漏」,而是「误杀」。一条正常评论被直接丢掉,用户不会来申诉,他只会走掉——而且你连数据都看不到。所以这套规则的所有命中结果都是待审核('0'),不是拒绝:把判断权留在人手里,管理员在后台一眼扫过、批量放行即可。
| 规则 | 判定 | 典型用途 |
|---|---|---|
| 敏感词 | 内容包含词表任一词条 | 广告、加微信、代刷(词表 || 分隔) |
| 必含中文 | 内容不含任何中文字符 | 对付纯英文机刷,最省事的一条 |
| 最大字数 | 内容长度超过阈值 | 长文里塞链接是常见套路 |
有一条工程约定值得单独说:敏感词表只在 PHP 侧比对,不下发到前端。如果为了「前端提前提示」把词表打进页面或 JS,等于把黑名单公开送给爬虫——它们会立刻换词。所以提示文案里只说规则,不说词。
实现上落在一个 WordPress 核心过滤器上:
// 命中 → 返回 '0'(待审核);未命中 → 原样返回
add_filter('pre_comment_approved', 'zdw_cg_filter_approved', 98, 2);

function zdw_cg_filter_approved($approved, $commentdata) {
    if (zdw_cg_hit($commentdata)) { return '0'; }
    return $approved;
}
为什么用这个过滤器而不是 comment_post 钩子?因为前者在入库前就决定了状态,一步到位;后者是「已经入库之后」的通知,那时再改状态就晚了,而且多一次写库。
二、坑①:管理员先被自己的规则拦住
功能上线,第一件事当然是自己去评论区测一条。结果——评论没出现,后台待审核列表里躺着它。规则把自己的主人拦下了。
这不是 bug,是规则太忠实。但对使用者来说,体验等同于「功能坏了」:站长会在自己的站上被自己的规则拦,然后开始怀疑代码。
修法是一行豁免:
// 可信角色豁免:有 moderate_comments 权限的人(管理员/编辑)不拦
if (function_exists('current_user_can') && current_user_can('moderate_comments')) {
    return '';
}教训:任何「拦截型」功能,都要先问一句「谁会来测它」。来测的人通常是管理员,而管理员恰恰是唯一有权限判断拦截是否合理的人——把他拦住,等于把唯一的裁判也罚下场。类似的豁免还有:白名单邮箱、已验证用户、站内作者。
三、坑②:命令行测试撞上「评论节流」,它伪装成你的 bug
第二个坑出现在自动化测试里。为了批量验证规则,写了个命令行脚本连续提交评论,结果脚本跑到第二条就中断了,没有任何 PHP 异常栈,只留下一句像是被 wp_die() 打断的痕迹。
第一反应是自己代码抛错了——毕竟中断点就在提交评论那一步。但排查后发现:是主题(或某个插件)的评论节流机制——同一来源在短时间内连续发评论,会被直接 wp_die()。
更麻烦的是:remove_all_filters() 之类的常规解绑手法对它无效——那个节流钩在别的地方(不是标准过滤器链)。
正解:把规则从提交链路里「拆出来」单独测
我们真正要测的是规则判定,不是WordPress 的评论入库流程。所以根本不需要发评论——直接调那个过滤器:
// 无需 HTTP、无需改数据库、不会触发任何节流
$r = apply_filters('pre_comment_approved', 1, array(
    'comment_content' => '这是一条正常的中文评论',
));
// $r === '0' → 被规则拦下(待审核);$r === 1 → 放行这样测的好处不止「绕过节流」:速度快到可以穷举边界——空串、纯符号、超长、全角数字、词表命中位置……一轮跑几十个用例不到一秒。
教训:测试失败时,先确认「失败的是被测对象还是测试环境」。这次中断来自节流(环境),却伪装成代码异常(被测对象)。一个可靠的判据:如果被测逻辑是纯函数,就压根不要通过 HTTP 或提交链路去测它。把规则抽成纯函数,是这门手艺里回报最高的一次重构。
四、坑③:空内容落在你没想到的那条规则上
写断言时很容易顺手写下「空评论应该被放行/由 WordPress 自己处理」——但在这套规则表里,空字符串会命中「必含中文」:它确实不含任何中文字符。
| 输入(开启「必含中文」时) | 命中规则 | 结果 |
|---|---|---|
| (空字符串) | no_cn | 待审核 |
hello world | no_cn | 待审核 |
!!! | no_cn | 待审核 |
正常中文 | — | 放行 |
这不是缺陷,是规则表的自然结果。但它会让「我以为空内容会走 X 分支」的断言直接失败,然后再花时间去代码里找一个并不存在的 bug。
教训:多规则叠加时,先把「规则 × 输入」的矩阵写出来,再动手写断言。规则一旦超过两条,「某个特殊输入落在哪一格」就不再是凭直觉能答对的问题了。
五、坑④:WordPress 自带的「首评必审」冒充成你的命中
第四个坑最阴:测试账号发了一条完全正常的中文评论,后台却显示待审核。看起来像是规则误判——但规则明明不该拦它。
真相在 WordPress 自己的「讨论」设置里:「评论者先前必须有一条被批准的评论」(选项名 comment_whitelist)。开启后,任何人的第一条评论都会进待审核,哪怕它干净得不能再干净。
| 来源 | 谁决定的 | 怎么确认 |
|---|---|---|
| 你的规则命中 | 本模块的判定函数 | 直接调 apply_filters('pre_comment_approved', 1, $data) 看返回值 |
| 首评必审 | WordPress 讨论设置 | 查 get_option('comment_whitelist');给该账号放行一条后再测 |
排查动作很简单:先放行一条该账号的评论,让它获得白名单身份,再测。如果这时就正常了,说明之前的待审核是 WordPress 干的,与你的规则无关。
教训:在别人的系统里做判断,必须先把「谁还有权改这个结果」列清楚。WordPress 的评论审核至少有三方参与:讨论设置、插件钩子、你的规则。只看最终状态(待审核/通过)是无法区分责任的——要能把每一方的判定单独取出来看。
六、这类规则该怎么验证
把上面的教训固化成四层断言,从「只测逻辑」到「端到端」:
| 层次 | 做法 | 能发现 |
|---|---|---|
| 纯函数单测 | 直接传数组给判定函数,穷举规则 × 输入矩阵 | 规则顺序、边界归属(坑③) |
| 集成 | 调 pre_comment_approved 过滤器,看返回值 | 钩子是否真的挂上、优先级是否合适 |
| 前台输出 | 抓页面 HTML,确认提示文案已注入且**不含词表** | 泄露词表 / 文案注入面 |
| 开关与还原 | 关掉开关后规则应完全失效;改完恢复配置快照 | 开关没接上 / 测试污染配置 |
第四条最容易被省掉,但它是唯一能保证「这次测试没有改变任何站点状态」的一层。做法是把配置项测前快照、测后比对,并用独立请求复核(同一进程里读配置可能命中静态缓存,看到的是旧值)。
附:同系列文章
本文属于「zibll 子主题开发实录」系列,同系列其它篇目见文末导航。
📚 zibll 子主题开发实录(共 22 篇) · 系列总目录与阅读路径 →
① 前端性能与加载
② 排版与样式系统
- 用 alt 后缀驱动的 WordPress 密集墙排版:从 float 到 flex-wrap 与纵向叠列
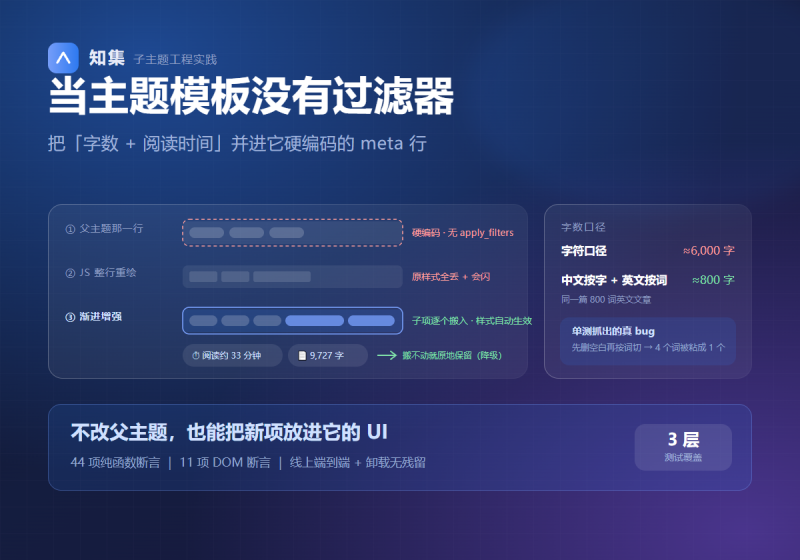
- 当主题模板没有过滤器:把「字数+阅读时间」并进它的 meta 行
- 设计令牌的最小实现:一个颜色变量驱动全站(附阅读进度条)
③ 功能实现与边界
- 一个 81 行的朗读按钮改了三轮:三个静默失效的坑
- 删数据类功能怎么写才不闯祸:一个「删文清附件」的六条边界
- 令牌模型与 lost update:一个只在并发时出现的计数 bug
- 「我填了 1 天,它却按 7 天算」:文章过期提示的四个边界
- 「历史上的今天」为什么永远是空的:三个不报错的死写法,与两个时区坑
- 文章系列卡片:一个 PHP 8 致命错误,和三处「不报错但白干」的写法
- 友链申请表单:一次越权写入,和一处「写了但不发」的死角
④ 系统与运维
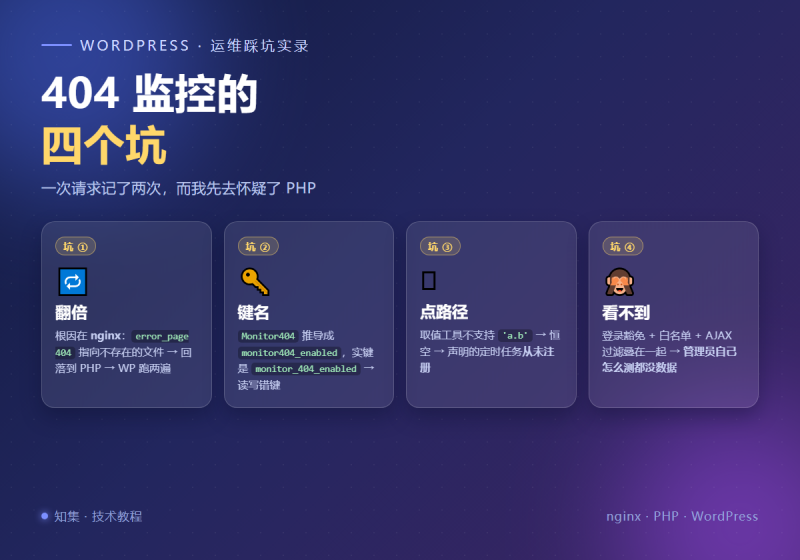
- 404 监控的四个坑:计数翻倍、键名推导、点路径取值、与「自己看不到数据」
- 评论反垃圾的四个坑:先被自己拦住、节流伪装失败、空内容归属、与「WP 原生背锅」 (本文)
- 页面缓存一次都没命中:六个静默失效,与一条 nonce 结构性保证
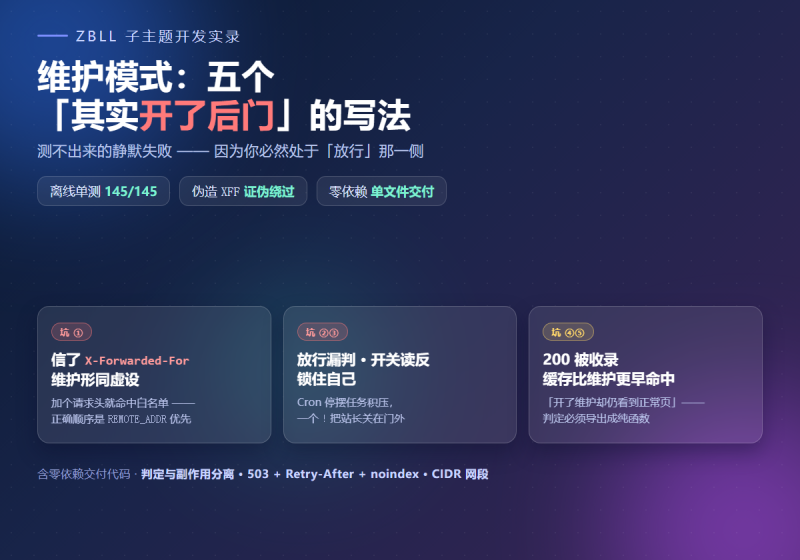
- 维护模式:五个「看起来在工作、其实开了后门」的写法
- WebP 自动转换:三个「上传成功、图片没变」的静默失效
- 安全扫描器:五个「扫了但没扫到」的坑,和一个实测确认的路径逃逸
⑤ 成就与活动系统
暂无评论内容